


LLM Prompt Caching VS Semantic Caching
LLM Prompt Caching VS Semantic Caching
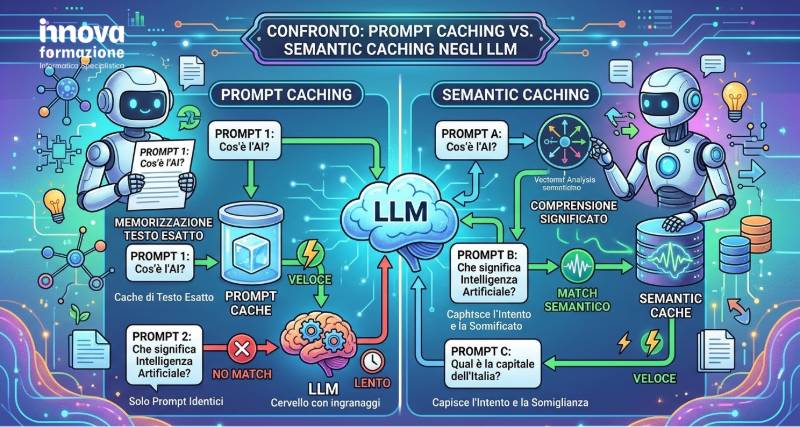
Prompt Caching e Semantic Caching servono entrambi a ridurre costi e latenza delle applicazioni LLM, ma intervengono in punti diversi della pipeline: il primo riutilizza l’elaborazione dell’input condiviso tra più richieste, il secondo riutilizza intere risposte già generate per domande equivalenti. In questa guida vediamo come funzionano, quando scegliere l’uno, l’altro o entrambi, quali rischi comportano e in quali scenari fanno risparmiare di più.
Immagina Marta, tech lead di una software house (personaggio di fantasia, ma la storia la conoscono in tanti). Il suo team ha appena lanciato un assistente per il supporto tecnico basato su LLM. Per due settimane tutti applaudono, poi arriva la fattura delle API ed è molto più alta del previsto. Marta apre i log e trova due colpevoli: ogni richiesta si porta dietro lo stesso manuale da decine di migliaia di token, e ogni giorno decine di utenti chiedono la stessa cosa con parole diverse. Due sprechi diversi, due rimedi diversi. Partiamo da qui.
Indice dei contenuti – LLM Prompt Caching VS Semantic Caching
1. Perché una richiesta a un LLM costa (e perché ripeterla è uno spreco)
2. Prompt Caching: riutilizzare l’elaborazione dell’input
3. Semantic Caching: riutilizzare la risposta
4. Il confronto in una tabella
5. Quando usare l’uno, quando l’altro, quando entrambi
6. I rischi del Prompt Caching
7. I rischi del Semantic Caching
8. Caso d’uso pratico: dove il Prompt Caching fa risparmiare di più
9. Caso d’uso pratico: dove il Semantic Caching fa risparmiare di più
10. Conclusioni e formazione professionale
1. Perché una richiesta a un LLM costa (e perché ripeterla è uno spreco)
Ogni volta che invii testo a un LLM, il modello lo divide in token: pezzi di testo che possono essere parole intere, frammenti di parola o segni di punteggiatura. Il conto a fine mese ha due voci principali: i token in ingresso e i token generati in uscita. Quelli in uscita di solito costano di più per unità, ma quelli in ingresso pesano per volume.
Il motivo è che l’input non è solo la domanda dell’utente. In un’applicazione reale c’è il prompt di sistema, ci sono gli esempi di risposte ben fatte, la documentazione di prodotto recuperata, la definizione dei tool, la cronologia della conversazione. Una domanda di dieci parole può viaggiare dentro una richiesta da migliaia di token.
Nei log di Marta si vedono due forme di ripetizione, ed è importante non confonderle:
- Ripetizione del contesto: il manuale di prodotto è identico in ogni richiesta, cambia solo la domanda (installazione, troubleshooting, impostazioni account).
- Ripetizione della domanda: cento utenti chiedono come cambiare la foto del profilo, ciascuno con parole sue, e il modello genera cento volte più o meno la stessa risposta.
Alla prima ripetizione risponde il Prompt Caching, alla seconda il Semantic Caching. Vediamoli uno alla volta.
2. Prompt Caching: riutilizzare l’elaborazione dell’input
Spiegamo il confronto fra LLM Prompt Caching VS Semantic Caching. Un modello transformer lavora in due fasi: prima elabora l’input (prefill), poi genera i token di output uno alla volta (decoding). Durante il prefill il modello calcola per ogni token degli stati intermedi, chiamati chiavi e valori (KV states), che gli permettono di guardare indietro ai token precedenti. La KV cache è la memoria di questi stati.
Pensa a un collega a cui consegni un manuale di 200 pagine prima di fargli una domanda. La prima volta deve leggerlo tutto. Se la volta dopo gli fai un’altra domanda sullo stesso manuale e lui si è tenuto i segnalibri, parte molto più veloce. Il Prompt Caching è quel segnalibro, condiviso tra richieste diverse.
La regola di riuso è il prefisso. In un modello causale la rappresentazione di un token dipende solo da ciò che lo precede, quindi se metti prima istruzioni e manuale e poi la domanda, la parte iniziale è identica tra una richiesta e l’altra e può essere riusata. Se invece metti la domanda prima del manuale, il manuale viene elaborato in modo diverso a ogni richiesta, anche se il testo è lo stesso.
E «identico» significa identico: stesso testo, stesso ordine dei documenti, stesse impostazioni di richiesta. Due istruzioni che dicono la stessa cosa con parole diverse non sono intercambiabili. Persino un timestamp o un ID di richiesta messo all’inizio può azzerare il riutilizzo di un grosso blocco di contesto.
Come lo offrono i provider (controlla sempre la documentazione ufficiale, perché regole e prezzi cambiano spesso):
- Anthropic: attivi la cache con il campo cache_control, a livello di richiesta (caching automatico) oppure su singoli blocchi (breakpoint espliciti, fino a quattro). Il prefisso segue l’ordine tool, system, messages. La durata predefinita è di 5 minuti, rinnovata a ogni utilizzo, con opzione a 1 ora. Esiste una lunghezza minima cacheable che dipende dal modello.
- OpenAI: il caching è attivo di default sui modelli supportati e richiede un match esatto del prefisso. Per GPT-5.6 e successivi la soglia minima è di 1.024 token, e puoi scegliere tra breakpoint impliciti ed espliciti e, nella Responses API, tra durate minime di 30 minuti o 12 ore.
- Google Gemini: due meccanismi, il caching implicito (attivo di default dai modelli 2.5 in poi, senza garanzia di risparmio) e il caching esplicito (lo configuri tu, con risparmio garantito).
Sul fronte costi la cache non è gratis: la lettura costa una frazione del prezzo di input normale, la scrittura un po’ di più. Per Anthropic la scrittura con TTL di 5 minuti costa 1,25 volte l’input base, quella a 1 ora 2 volte, la lettura 0,1 volte (su alcuni modelli ancora meno). OpenAI, per GPT-5.6 e successivi, indica scrittura a 1,25× per 30 minuti e lettura a 0,1× sulla maggior parte dei modelli. Con un prefisso che costerebbe 1, una scrittura più una lettura valgono 1,35 invece di 2, e con una scrittura e nove letture si arriva a 2,15 invece di 10. Se invece il prefisso non viene mai riusato, hai pagato la scrittura per niente. Resta fermo che il Prompt Caching non cambia la generazione dell’output: i token in uscita si pagano uguale e la risposta nasce da zero ogni volta.
3. Semantic Caching: riutilizzare la risposta – LLM Prompt Caching VS Semantic Caching
Il Semantic Caching vive nel livello applicativo che circonda l’LLM, oppure in un servizio separato interrogato prima di arrivare al modello. Non ha nulla a che fare con gli stati interni del modello: riutilizza la risposta già generata.
Prendi due domande: «Dove trovo l’impostazione per la modalità scura?» e «Come faccio a passare l’app al tema scuro?». Un confronto testuale le considera diverse. Un confronto semantico capisce che chiedono la stessa cosa. Pensa a un bibliotecario esperto: non ha bisogno che gli rifai la domanda con le stesse parole per ricordarsi dove sta il libro.
Per farlo serve un modello di embedding, che trasforma il testo in un vettore di numeri confrontabile con altri. Il flusso tipico è questo:
- Passo 1: calcoli l’embedding della domanda in arrivo.
- Passo 2: cerchi tra i vettori delle domande già salvate, di solito con un indice di ricerca approssimata come HNSW.
- Passo 3: confronti il punteggio di similarità con una soglia e verifichi che la risposta candidata sia valida per questa richiesta.
- Passo 4 (hit): restituisci la risposta salvata, senza chiamare l’LLM.
- Passo 5 (miss): chiami l’LLM, e salvi la nuova coppia domanda-risposta, di norma con un TTL.
Su un hit risparmi l’intera chiamata: input, output e attesa. Ma embedding, ricerca e storage si pagano comunque, e su una miss li paghi in aggiunta alla chiamata normale. In altre parole, una miss costa più di nessuna cache.
Le cifre che circolano vanno lette come esempi, non come promesse. Uno studio su arXiv (GPT Semantic Cache, basato su Redis) riporta riduzioni delle chiamate API fino al 68,8% nei propri esperimenti, mentre Redis parla di latenze ridotte del 40-50% sulle risposte servite dalla cache. Il tuo risultato dipenderà da quanto si ripetono davvero le domande nel tuo dominio.
Sulla soglia, Redis indica per i sistemi in produzione valori tra 0,7 e 0,95 e consiglia di partire in modo conservativo, da 0,9 in su. Redis suggerisce anche un’architettura a strati: prima una cache esatta per le query identiche (zero falsi positivi), poi quella semantica per la coda lunga. Nel supporto, per esempio, «status code 403» può essere servito da un match esatto e «access forbidden error» da un match semantico.
4. Il confronto in una tabella – LLM Prompt Caching VS Semantic Caching
Prima di entrare nei dettagli, ecco le differenze principali una accanto all’altra.
| Aspetto | Prompt Caching | Semantic Caching |
| Cosa riutilizza | Lo stato interno dell’elaborazione del prefisso dell’input | Una risposta completa già generata |
| Dove vive | Infrastruttura del provider o del motore di inferenza | Nel tuo livello applicativo (vector store, gateway, servizio dedicato) |
| Criterio di match | Prefisso identico, token per token | Similarità vettoriale sopra una soglia, più filtri di scope |
| Cosa fa risparmiare | Parte del costo e della latenza dell’input | L’intera chiamata (input e output) in caso di hit |
| La risposta | Sempre generata da zero | Può essere quella data a una domanda precedente |
| Rischio principale | Miss silenziosi e scritture mai ripagate | Risposte sbagliate, obsolete o non autorizzate |
| Cosa misurare | Token letti da cache sul totale dei token in input | Precisione, freschezza, scope e hit rate |
| Effort di adozione | Basso: spesso è automatico o quasi | Alto: embedding, vector store, soglia, invalidazione |
La differenza che conta di più per chi progetta è questa: il Prompt Caching non rischia mai di darti la risposta sbagliata, perché il modello genera ogni volta un output nuovo sul contesto corrente. Il Semantic Caching sì, perché per definizione ti restituisce una risposta scritta per un’altra domanda.
5. Quando usare l’uno, quando l’altro, quando entrambi – LLM Prompt Caching VS Semantic Caching
Usa il Prompt Caching quando hai un contesto lungo e stabile e domande sempre diverse. Pensa a manuali, documentazione, definizioni di tool, esempi few-shot, porzioni di codebase, cronologia di conversazioni lunghe e agenti che fanno molte chiamate di fila sullo stesso contesto. Funziona bene anche quando le risposte devono essere personalizzate o fresche, perché il modello le genera ogni volta.
Usa il Semantic Caching quando la stessa risposta va bene per molte richieste diverse: FAQ di prodotto, istruzioni di supporto stabili, domande su policy che cambiano raramente, knowledge base aziendali. Evitalo quando l’output deve essere personalizzato, quando dipende da fatti che cambiano in fretta, quando serve creatività nuova a ogni richiesta.
Ci vuole particolare cura con le richieste che causano azioni. Una risposta in cache che dice «Abbonamento cancellato» non può sostituire una cancellazione vera.
Usali insieme quando hai entrambe le ripetizioni, come l’assistente di Marta. L’ordine ragionevole è questo:
- Prima una cache esatta, economica, per le richieste identiche.
- Poi la cache semantica, con filtri su cliente, permessi, lingua, versione di prodotto e versione dei dati sorgente.
- Solo se non c’è un hit valido, chiami l’LLM, sfruttando il prompt caching sul prefisso condiviso.
La cache semantica non deve per forza essere il primo passo in assoluto. Se per validare una risposta devi recuperare la versione corrente delle fonti, quel controllo viene prima. Dai inoltre alla ricerca semantica un tempo massimo con fallback sulla generazione normale, e misura separatamente la latenza di hit, miss e timeout.
La regola pratica in una riga: se ciò che si ripete è il contesto, usa il Prompt Caching. Se ciò che si ripete è la domanda, usa il Semantic Caching. Se si ripetono entrambi, metti i due livelli in cascata.
6. I rischi del Prompt Caching
Il Prompt Caching è il più sicuro dei due, ma ha i suoi trabocchetti, e quasi tutti sono silenziosi: il sistema funziona, la risposta arriva, e tu paghi il prezzo pieno senza accorgertene.
- Miss silenziosi. Un timestamp o un ID casuale in apertura, un ordine diverso dei documenti, una modifica ai tool o alle impostazioni di ragionamento possono invalidare tutto o parte del prefisso. Nella documentazione Anthropic, per esempio, modificare le definizioni dei tool invalida l’intera cache, mentre cambiare tool_choice o aggiungere immagini invalida i blocchi dei messaggi. Perfino l’ordine delle chiavi nei JSON dei tool_use, se il tuo linguaggio lo randomizza, può rompere la cache.
- Breakpoint nel posto sbagliato. Se segni come riusabile un blocco che cambia a ogni richiesta, scrivi una nuova voce di cache ogni volta e non leggi mai niente. Il punto giusto è l’ultimo blocco identico tra le richieste.
- Scritture mai ripagate. Se il prefisso non viene riutilizzato prima della scadenza (5 minuti di default su Anthropic, 30 minuti su OpenAI per GPT-5.6 e successivi), hai pagato un sovrapprezzo di scrittura senza alcuna lettura. Con traffico basso e irregolare il caching può costarti più che non averlo.
- Privacy e isolamento. Le cache non sono condivise tra organizzazioni, e su Anthropic sono isolate anche per workspace. OpenAI segnala il rischio di «cache-hit probing», cioè dedurre se un contenuto è già in cache osservando i risultati, e suggerisce di usare chiavi separate per cliente o utente.
- Contenuto obsoleto. La cache non sa se la tua regola di business è cambiata. Se continui a inviare la vecchia policy nel prompt, il modello continuerà a usarla: recuperare le informazioni correnti resta responsabilità dell’applicazione.
La difesa è la misurazione. Tutti i provider espongono nella risposta i token letti e scritti da cache (per esempio cache_read_input_tokens su Anthropic, cached_tokens su OpenAI). Calcola il rapporto tra token letti e token totali in input, per cliente e per giorno, e confrontalo con quello che ti aspettavi. OpenAI e Anthropic offrono anche strumenti di diagnostica per capire dove il prefisso è cambiato tra una richiesta e l’altra.
7. I rischi del Semantic Caching
Il Semantic Caching dà risparmi più grandi per singola richiesta, ma i suoi errori sono visibili all’utente. Ecco i rischi principali.
- Falsi positivi. Pensa a «Posso annullare l’ordine prima della spedizione?» e «Posso annullare l’ordine dopo la spedizione?». Gli embedding sono vicinissimi, ma la risposta «Sì, l’annullamento è disponibile» è giusta per una e sbagliata per l’altra. Lo stesso accade con numeri, negazioni, date, edizioni di prodotto e condizioni di idoneità: «Il piano Basic include i backup?» non può riusare la risposta sul piano Pro.
- Punteggio non vuol dire probabilità. Una similarità di 0,92 non significa che la risposta in cache sia giusta nel 92% dei casi. Il significato del punteggio dipende dal modello di embedding e dal metodo di confronto, e alcuni sistemi espongono una distanza invece di una similarità.
- Contesto mancante, il rischio più grave. «Qual è lo stato del mio ordine?» dipende dal cliente. «Supporta l’accesso offline?» dipende da cosa significhi «lo» nella conversazione. Una risposta in inglese non va servita a chi la chiede in italiano. Servono filtri di scope (cliente o organizzazione, permessi, versione di prodotto, lingua, stato della conversazione, versione dei dati sorgente), e vanno applicati dal tuo codice: non puoi sperare che un modello di embedding distingua i clienti. Sbagliare qui significa servire dati di un cliente a un altro.
- Invalidazione. Se la policy di reso passa da 30 a 14 giorni, la cache continuerà a dire 30 finché non la invalidi. Hai tre leve: il TTL (limita l’età dell’informazione, ma non garantisce freschezza prima della scadenza), il versioning (una risposta salvata con policy_version=12 non è valida quando l’applicazione si aspetta la 13) e le impostazioni di generazione (se cambiano istruzioni, formato o comportamento del modello, le vecchie risposte vanno scartate). Il versioning globale è semplice ma invalida tutto a ogni piccolo aggiornamento, quello selettivo è più efficiente ma richiede di tracciare quali risposte dipendono da quali documenti.
Come difendersi? Con una valutazione seria. Raccogli dai log 100-500 richieste reali, etichetta quando il riuso di una risposta è corretto, includi sia parafrasi legittime sia near-miss difficili, e misura la precisione (quanti hit sono corretti) oltre al hit rate. Redis indica come obiettivo almeno il 95% di precisione prima di andare in produzione. Un hit rate alto, da solo, non è un risultato da festeggiare. Aggiungi monitoraggio continuo e un campionamento periodico delle risposte servite dalla cache.
8. Caso d’uso pratico: dove il Prompt Caching fa risparmiare di più
Passiamo alla pratica parlando di LLM Prompt Caching VS Semantic Caching. Torniamo da Marta. Il suo assistente invia a ogni richiesta le istruzioni di supporto e il manuale completo del prodotto: circa 60.000 token identici, seguiti da una domanda di una cinquantina di token. Le domande sono tutte diverse, perché ogni utente ha un problema suo su una versione sua. Il traffico è regolare: nessuna pausa superiore a pochi minuti.
Mettiamo dei numeri, puramente illustrativi: 2.000 richieste al giorno, un prezzo ipotetico di 2 dollari per milione di token in input, lettura da cache a 0,1× e scrittura a 1,25×, con una decina di riscritture al giorno per deploy e pause di traffico.
- Senza cache: 2.000 × 60.050 token = circa 120,1 milioni di token, cioè circa 240 dollari al giorno di input.
- Con Prompt Caching: 10 scritture da 60.000 token a 1,25× (0,75 milioni di token equivalenti), 1.990 letture a 0,1× (11,94 milioni), più 0,1 milioni di token non in cache. Totale circa 12,8 milioni di token equivalenti, cioè circa 26 dollari al giorno.
Il costo dell’input scende di quasi il 90%, e con la stessa ricetta migliora anche il tempo al primo token. I token in uscita, invece, costano come prima.
Perché qui il Semantic Caching non servirebbe? Perché ogni domanda è diversa e la risposta va costruita leggendo il manuale ogni volta: il hit rate sarebbe bassissimo, e avresti aggiunto embedding e rischio di risposte sbagliate per niente. Qui ciò che si ripete è il contesto, non la domanda.
Cosa fa il team per far funzionare tutto:
- Mette in testa istruzioni e manuale, e in coda la domanda e qualsiasi dato variabile (data, ID sessione, nome utente).
- Piazza il breakpoint sull’ultimo blocco davvero stabile, cioè la fine del manuale.
- Pre-riscalda la cache all’avvio e dopo ogni deploy: sia Anthropic sia OpenAI offrono questa possibilità, per non far pagare il primo utente.
- Monitora ogni giorno i token letti da cache sul totale, e indaga appena il rapporto cala.
9. Caso d’uso pratico: dove il Semantic Caching fa risparmiare di più
Cambiamo scenario. Un’azienda SaaS ha un chatbot di helpdesk che risponde a 10.000 richieste al giorno. Una buona fetta riguarda poche decine di temi ricorrenti: reset della password, download della fattura, attivazione della modalità scura, limiti del piano. Gli utenti li chiedono in mille modi diversi, ma la risposta giusta è sempre la stessa. Il prompt di sistema è breve, spesso sotto la lunghezza minima che i provider richiedono per attivare il caching: qui il Prompt Caching non avrebbe praticamente nulla da riusare.
Ancora numeri illustrativi: costo medio di una chiamata all’LLM pari a 0,01 dollari, costo di embedding e ricerca pari a 0,0005 dollari per richiesta, hit rate del 35% raggiunto dopo aver tarato la soglia sui log reali.
- Senza cache: 10.000 × 0,01 = 100 dollari al giorno.
- Con Semantic Caching: embedding e ricerca su tutte le richieste (5 dollari) più chiamate all’LLM sulle sole miss (6.500 × 0,01 = 65 dollari). Totale 70 dollari al giorno, circa il 30% in meno.
Il break-even è facile da calcolare: costo di lookup diviso costo di chiamata, cioè 0,0005 / 0,01 = 5%. Sotto un hit rate del 5%, la cache ti fa perdere soldi. In più, le risposte servite dalla cache arrivano in una frazione del tempo di una generazione.
Perché qui il Semantic Caching risparmia di più? Perché un hit elimina tutta la chiamata, input e output, mentre il Prompt Caching avrebbe tagliato solo parte dell’input di un prompt già corto. Qui ciò che si ripete è la domanda, e la risposta è uguale per tutti.
Le protezioni indispensabili:
- Cache partizionata per lingua, versione del prodotto e piano tariffario.
- Esclusione delle domande personali («dov’è la mia fattura?», «a che punto è il mio ordine?»), che non devono mai passare dalla cache condivisa.
- TTL e versioning legati agli aggiornamenti della documentazione.
- Soglia conservativa all’inizio, misurata su un dataset etichettato.
10. Conclusioni e formazione professionale
Marta ha risolto il suo problema senza cambiare modello e senza stravolgere l’architettura: ha capito quale ripetizione stava pagando e ha scelto la strategia giusta. Questa è la lezione tecnica. Il prompt caching taglia il costo di ciò che si ripete nel contesto, il semantic caching evita di rigenerare ciò che si ripete nelle domande, e usarli bene significa conoscerne i limiti, le soglie, le invalidazioni e le metriche.
Ed è anche la lezione organizzativa. Lo sviluppo AI e le applicazioni basate su LLM sono ormai all’ordine del giorno: ogni azienda software, e sempre più spesso ogni PMI, ha in cantiere un assistente, un agente o un sistema RAG. I team che non sanno lavorare in questo ambito rischiano di rimanere indietro, e di scoprire gli errori (di costo, di sicurezza, di qualità delle risposte) soltanto quando arriva la fattura o il reclamo di un cliente. Solo una buona formazione può garantire un approccio rapido e senza errori verso queste nuove tecnologie.
Se vuoi portare il tuo team a questo livello, ti consiglio il Corso sviluppo applicazioni LLM di Innovaformazione, rivolto alle aziende. Il calendario è da concordare e personalizzare in base alle esigenze del tuo team, e il corso si svolge online in classe virtuale. È inoltre possibile finanziarlo con Fondimpresa.
Contatti
Per dettagli e preventivi: Dario Carrassi, info@innovaformazione.net, tel. 3471012275
Per altri articoli tecnici consigliamo di navigare sul nostro blog QUI.
Articoli correlati

Claude Code con Arduino

Novità .Net 11

Backdoor nei modelli AI open-weight

Opportunità di lavoro Bari

Spieghiamo il Weight space programming
