


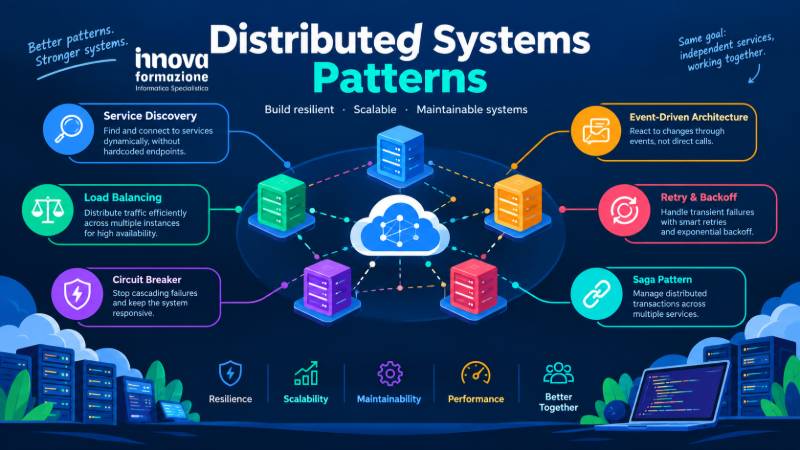
Distributed Systems Patterns
Distributed Systems Patterns
I sistemi distribuiti moderni, dalle architetture a microservizi alle piattaforme cloud-native, si fondano su un insieme ricorrente di pattern architetturali che risolvono problemi di disponibilità, scalabilità e coerenza dei dati. Questo articolo offre una panoramica accademica ma accessibile dei pattern più rilevanti: replication, sharding, consistent hashing, publish/subscribe, retry with backoff, circuit breaker, leader election, quorum reads/writes e saga, con relative best practice, vantaggi, svantaggi ed esempi pratici.
Indice dei contenuti – Distributed Systems Patterns
- Introduzione ai sistemi distribuiti
- Replication
- Sharding
- Consistent Hashing
- Publish/Subscribe
- Retry with Backoff
- Circuit Breaker
- Leader Election
- Quorum Reads/Writes
- Saga Pattern
- Conclusioni: perché le competenze non si improvvisano
1. Introduzione ai sistemi distribuiti
Un sistema distribuito è un insieme di componenti autonomi, dislocati su nodi fisici o logici differenti, che cooperano per fornire un servizio unificato al client finale. La letteratura accademica di riferimento (Lamport, Brewer) individua tre vincoli strutturali, noti come teorema CAP, che governano ogni progettazione: in presenza di una partizione di rete, un sistema deve scegliere tra coerenza (Consistency) e disponibilità (Availability), non potendo garantire entrambe simultaneamente insieme alla tolleranza di partizione (Partition tolerance).
I pattern descritti in questo articolo non sono alternativi tra loro: nella pratica industriale (Amazon, Google, Microsoft, Netflix) vengono combinati per costruire piattaforme resilienti. Comprenderne singolarmente il funzionamento è il primo passo per progettare architetture a microservizi correttamente dimensionate.
2. Replication – Distributed Systems Patterns
La replicazione consiste nel mantenere più copie sincronizzate dello stesso dato su nodi differenti, con l’obiettivo di aumentare la disponibilità del servizio e la tolleranza ai guasti. Le due strategie principali sono la replicazione sincrona, in cui la scrittura è confermata solo dopo che tutte (o una quota) delle repliche l’hanno applicata, e la replicazione asincrona, in cui il nodo primario conferma la scrittura prima che le repliche l’abbiano recepita.
Best practice: definire esplicitamente il fattore di replica in base al livello di criticità del dato; monitorare il replication lag; separare i nodi di lettura (read replica) da quelli di scrittura per distribuire il carico applicativo.
Vantaggi: maggiore disponibilità in caso di guasto di un nodo, possibilità di scalare orizzontalmente le operazioni di lettura, riduzione della latenza geografica se le repliche sono distribuite su più regioni.
Svantaggi: overhead di sincronizzazione, rischio di inconsistenza temporanea nei modelli asincroni, complessità operativa nella gestione dei conflitti di scrittura concorrente.
Esempio pratico: un e-commerce mantiene tre repliche del catalogo prodotti in tre data center europei. Le scritture avvengono sul nodo primario di Francoforte, mentre le letture dei visitatori italiani vengono servite dalla replica più vicina, riducendo la latenza percepita senza appesantire il nodo principale.
3. Sharding
Lo sharding è la partizione orizzontale dei dati: un singolo dataset viene suddiviso in sottoinsiemi (shard) distribuiti su nodi fisicamente distinti, ciascuno responsabile di una porzione del carico. È la tecnica principale per superare i limiti di capacità verticale di un singolo database.
Best practice: scegliere una shard key ad alta cardinalità e con distribuzione uniforme degli accessi, per evitare ‘hot shard’; pianificare in anticipo la strategia di ribilanciamento; combinare sharding e replication all’interno di ogni singolo shard.
Vantaggi: scalabilità quasi lineare della capacità di scrittura e di storage, isolamento dei guasti a livello di singolo shard.
Svantaggi: query cross-shard costose o impossibili senza un livello di orchestrazione aggiuntivo, complessità di migrazione dei dati quando si aggiungono o rimuovono shard, rischio di sbilanciamento (shard skew) se la chiave è scelta male.
Esempio pratico: una piattaforma di messaggistica distribuisce le conversazioni degli utenti su dieci shard database, usando l’identificativo utente come shard key, in modo che tutte le conversazioni di uno stesso utente risiedano sullo stesso shard e le query restino locali.
4. Consistent Hashing
Il consistent hashing è una tecnica di distribuzione delle chiavi su un insieme di nodi organizzati logicamente su un anello (ring). A differenza dello sharding basato su modulo, quando un nodo viene aggiunto o rimosso solo una piccola frazione delle chiavi deve essere ridistribuita, invece dell’intero dataset.
Best practice: utilizzare virtual node multipli per nodo fisico per migliorare l’uniformità della distribuzione; monitorare il bilanciamento del carico sull’anello; prevedere una strategia di replica sui nodi successivi sull’anello per la tolleranza ai guasti.
Vantaggi: ribilanciamento minimo in caso di scaling orizzontale, riduzione dell’effetto cascata durante le operazioni di manutenzione dei nodi.
Svantaggi: complessità implementativa superiore rispetto allo sharding statico, necessità di gestire correttamente i virtual node per evitare distribuzioni disomogenee.
Esempio pratico: un sistema di cache distribuita utilizza il consistent hashing per instradare le chiavi verso i nodi memcached disponibili; quando un nodo cade, solo le chiavi a esso assegnate vengono ridistribuite ai nodi adiacenti sull’anello, senza invalidare l’intera cache.
5. Publish/Subscribe
Il pattern publish/subscribe disaccoppia produttori e consumatori di messaggi attraverso un intermediario (broker o topic): i publisher inviano messaggi su un topic senza conoscere i destinatari, mentre i subscriber ricevono i messaggi di interesse in modo asincrono.
Best practice: progettare messaggi idempotenti per gestire eventuali duplicazioni; definire una politica di dead-letter queue per i messaggi non processabili; dimensionare correttamente il numero di subscription in base al throughput atteso.
Vantaggi: disaccoppiamento temporale e logico tra i servizi, scalabilità dei consumer in modo indipendente dai producer, resilienza a picchi di traffico grazie al buffering dei messaggi.
Svantaggi: consistenza eventuale per definizione, complessità di debug nei flussi asincroni, necessità di gestire l’ordinamento dei messaggi quando l’ordine è rilevante per il dominio applicativo.
Esempio pratico: un servizio di gestione ordini pubblica un evento ‘ordine confermato’ su un topic; in modo indipendente, il servizio di fatturazione, quello di logistica e quello di notifiche si sottoscrivono allo stesso topic ed elaborano l’evento secondo la propria logica, senza chiamate dirette tra i servizi.
6. Retry with Backoff
Il pattern retry with backoff prevede il ritentativo automatico di un’operazione fallita, aumentando progressivamente l’intervallo tra un tentativo e il successivo (backoff esponenziale), tipicamente arricchito da una componente casuale (jitter) per evitare che più client ritentino simultaneamente.
Best practice: applicare timeout distinti per la connessione e per la richiesta; limitare il numero massimo di tentativi con un tetto (capped exponential backoff); ritentare solo su errori transitori (es. timeout, errori 5xx) e non su errori applicativi permanenti; concentrare la logica di retry in un unico punto della catena di chiamate per evitare l’amplificazione del carico su più livelli.
Vantaggi: maggiore resilienza a guasti temporanei di rete o di servizio, riduzione degli errori visibili all’utente finale.
Svantaggi: rischio di aggravare un sovraccarico esistente se il backoff non è ben calibrato, necessità di garantire l’idempotenza delle operazioni ripetute.
Esempio pratico: un client che chiama un servizio di pagamento esterno ritenta la richiesta fallita dopo 1, 2 e 4 secondi (con jitter casuale), fermandosi dopo tre tentativi e restituendo un errore controllato all’utente se il servizio resta irraggiungibile.
7. Circuit Breaker
Il circuit breaker è un pattern di resilienza che interrompe temporaneamente le chiamate verso un servizio che sta fallendo ripetutamente, evitando di sprecare risorse in attese di timeout e prevenendo l’effetto cascata dei guasti. Il pattern prevede tre stati: chiuso (funzionamento normale), aperto (le chiamate vengono rifiutate immediatamente) e semi-aperto (un numero limitato di richieste di prova viene lasciato passare per verificare il ripristino).
Best practice: definire soglie di apertura basate su tassi di errore osservati piuttosto che su valori arbitrari; combinare il circuit breaker con timeout e retry con backoff; esporre metriche sullo stato del circuito per l’osservabilità operativa.
Vantaggi: protezione dei servizi downstream da sovraccarico, tempi di risposta più rapidi in presenza di guasti, possibilità di rilevare automaticamente il ripristino del servizio.
Svantaggi: comportamento ‘modale’ che può risultare difficile da testare in modo esaustivo, necessità di calibrare correttamente soglie e finestre temporali per evitare falsi positivi.
Esempio pratico: un gateway API smette di inoltrare richieste verso un microservizio di raccomandazioni dopo cinque errori consecutivi, restituendo per trenta secondi una risposta di fallback (ad esempio una lista di prodotti generica), prima di ritentare con richieste di prova.
8. Leader Election – Distributed Systems Patterns
Il leader election è il meccanismo con cui, tra più istanze equivalenti di un componente, se ne designa una come coordinatrice (leader) responsabile di decisioni che richiedono un punto unico di autorità, mentre le altre restano in attesa (follower) pronte a subentrare in caso di guasto.
Best practice: affidarsi a primitive di consenso consolidate (Raft, Paxos) o a servizi di coordinamento gestiti piuttosto che implementare l’algoritmo da zero; impostare tempi di lease e di rinnovo coerenti con la tolleranza ai guasti richiesta; prevedere una gestione esplicita dello split-brain.
Vantaggi: punto di decisione univoco che semplifica la coerenza operativa, failover automatico in caso di guasto del leader.
Svantaggi: il leader può diventare un collo di bottiglia per le operazioni che richiede di coordinare, complessità nella gestione delle transizioni di leadership durante gli aggiornamenti del cluster.
Esempio pratico: in un cluster Kubernetes ad alta disponibilità, più istanze del controller manager competono per l’acquisizione di una risorsa Lease; solo l’istanza che detiene la lease attiva la logica di riconciliazione, mentre le altre restano in standby pronte a subentrare.
9. Quorum Reads/Writes – Distributed Systems Patterns
Nei sistemi con dati replicati su N nodi, il pattern quorum stabilisce che un’operazione di scrittura sia considerata riuscita solo dopo la conferma di almeno W repliche, e una lettura sia considerata affidabile solo se interroga almeno R repliche. Quando la somma di R e W supera N, il sistema garantisce che almeno una replica coinvolta nella lettura contenga l’ultima scrittura confermata.
Best practice: calibrare i valori di R e W in base al compromesso desiderato tra coerenza, disponibilità e latenza; documentare esplicitamente il livello di consistenza scelto per ogni tipo di operazione; monitorare la latenza di coda (tail latency) generata dall’attesa delle repliche più lente.
Vantaggi: possibilità di modulare in modo granulare il compromesso tra coerenza forte e disponibilità, tolleranza a guasti di singoli nodi senza bloccare le operazioni.
Svantaggi: aumento della latenza percepita al crescere del quorum richiesto, maggiore complessità nella gestione dei conflitti quando la coerenza non è forte.
Esempio pratico: un database distribuito con cinque repliche (N=5) richiede la conferma di tre nodi per ogni scrittura (W=3) e l’interrogazione di tre nodi per ogni lettura (R=3): poiché R+W supera N, ogni lettura intercetta necessariamente almeno una replica aggiornata.
10. Saga Pattern -Distributed Systems Patterns
Il pattern saga gestisce la coerenza dei dati attraverso più servizi in assenza di transazioni distribuite ACID, scomponendo un’operazione complessa in una sequenza di transazioni locali. Ogni transazione locale aggiorna il proprio servizio e pubblica un evento che avvia il passo successivo; in caso di fallimento, vengono eseguite transazioni di compensazione che annullano gli effetti dei passi già completati.
Best practice: distinguere chiaramente tra coreografia (coordinamento tramite eventi, senza un orchestratore centrale) e orchestrazione (un componente dedicato dirige l’intero flusso); progettare ogni passo come compensabile fin dalla fase di analisi; identificare la ‘transazione pivot’ oltre la quale non è più possibile tornare indietro.
Vantaggi: consistenza dei dati su più servizi senza ricorrere al two-phase commit, disaccoppiamento dei servizi coinvolti.
Svantaggi: assenza di isolamento tra transazioni concorrenti nella fase intermedia, complessità di progettazione delle logiche di compensazione, difficoltà di debug end-to-end rispetto a una transazione ACID classica.
Esempio pratico: un processo di acquisto online coinvolge in sequenza il servizio ordini, il servizio pagamenti e il servizio magazzino; se il pagamento va a buon fine ma il magazzino segnala l’esaurimento del prodotto, viene eseguita una transazione di compensazione che rimborsa il pagamento e annulla l’ordine.
11. Conclusioni: perché le competenze non si improvvisano
I pattern descritti in questo articolo non sono nozioni teoriche isolate: nel mercato attuale delle applicazioni a microservizi e delle architetture cloud, la combinazione corretta di replication, sharding, consistent hashing, pub/sub, retry with backoff, circuit breaker, leader election, quorum e saga determina concretamente l’affidabilità e la scalabilità dei sistemi in produzione. Applicare questi pattern senza una preparazione adeguata espone le aziende a rischi operativi seri: incidenti a cascata, perdita di dati, downtime prolungati e costi di rimedio elevati.
Le competenze necessarie per progettare, implementare e mantenere sistemi distribuiti robusti richiedono formazione strutturata e pratica guidata: non si acquisiscono per tentativi in produzione. Per questo motivo, investire nella formazione dei team di sviluppo e IT operations rappresenta oggi una scelta strategica, non accessoria.
Innovaformazione propone percorsi formativi dedicati a queste tematiche, pensati per team aziendali:
I corsi vengono attivati su richiesta, con modalità online in aula virtuale, e sono progettati specificamente per le esigenze delle aziende. Per informazioni e preventivi personalizzati è possibile contattare Dario Carrassi all’indirizzo info@innovaformazione.net oppure al numero 347 1012275.
Per altri articoli tecnici di settore consigliamo di navigare sul nostro blog alla apposita sezione QUI.
Articoli correlati

Claude Code con Arduino

Novità .Net 11

Backdoor nei modelli AI open-weight

Opportunità di lavoro Bari

Spieghiamo il Weight space programming
