


Differenza AI Open weight ed Open source
Differenza AI Open weight ed Open source
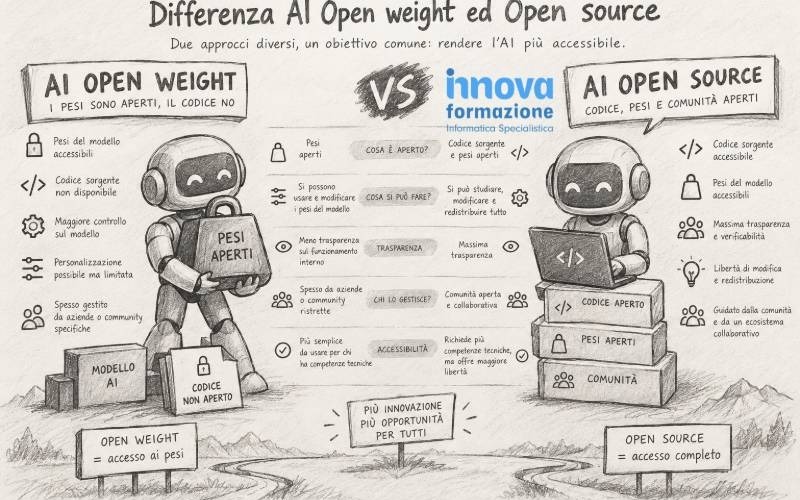
Un modello open weight ti consegna i pesi addestrati: li scarichi, li esegui sulla tua infrastruttura e, se la licenza lo consente, li adatti. Un modello open source secondo la definizione OSI ti dà anche tutto ciò che serve per studiarlo, modificarlo e ricostruirlo: codice, parametri e informazioni sufficienti sui dati di training. A ottobre 2026 i modelli «aperti» di punta (DeepSeek, Qwen, Mistral, Gemma, gpt-oss) sono quasi tutti open weight con licenze permissive; i modelli fully open come Olmo 3 sono una minoranza. Qui trovi la differenza spiegata con esempi di codice, un approfondimento su DeepSeek V4.1, una tabella di confronto e gli scenari di competizione.
Dati verificati il 5 ottobre 2026 su fonti ufficiali (produttori, OSI, Hugging Face). I benchmark citati sono dichiarati dai produttori e non sono confrontabili tra loro senza verificare metodologia e configurazione.
Indice dei contenuti – Differenza AI Open weight ed Open source
1. Open weight e open source: la definizione che conta
2. Anatomia di un rilascio: cosa c’è davvero nel repository
3. Licenze: permissive, custom e restrizioni d’uso
4. Stato dell’arte a ottobre 2026
6. Costi inferiori e limiti infrastrutturali
7. Esempio pratico 1: verificare licenza e contenuto di un modello con Python
8. Esempio pratico 2: stesso codice client su modello locale e su API open weight
9. Tabella comparativa: differenze tecniche e di performance
10. Scenari futuri e competizione
11. Conclusioni, fonti e formazione professionale
1. Open weight e open source: la definizione che conta
Analogia da sviluppatore: un modello open weight è un binario compilato distribuito con una licenza; un modello open source è il repository completo con una build riproducibile. Con il binario puoi eseguire, wrappare, a volte patchare (fine-tuning). Solo con il repository puoi rifare la build e verificare cosa c’è dentro.
La definizione di riferimento è la Open Source AI Definition (OSAID) 1.0 pubblicata dalla Open Source Initiative il 28 ottobre 2024. Come per il software, un sistema AI è open source se concede quattro libertà: usarlo per qualsiasi scopo senza chiedere permesso, studiarlo, modificarlo e condividerlo. La precondizione è l’accesso alla «forma preferita per apportare modifiche». Per un modello questo significa pesi, codice e informazioni sui dati di training abbastanza dettagliate da permettere a una persona competente di ricreare un sistema sostanzialmente equivalente.
Ai2 (Allen Institute for AI) usa una tassonomia pratica in tre livelli:
- Open weight: solo il checkpoint finale, con poche o nessuna informazione su dati e ricetta di training.
- Partially open: pesi e buona parte di dati o dettagli di riproduzione.
- Fully open: pesi, dati di training, codice e valutazioni pubblici, quindi ispezionabile e riproducibile.
Conseguenza che sorprende molti team: una licenza permissiva sui pesi non rende il modello open source. Un modello con pesi sotto MIT o Apache 2.0 ma senza dati e codice di training resta open weight.
2. Anatomia di un rilascio: cosa c’è davvero nel repository
Un rilascio AI è uno stack di quattro livelli. Per capire a che categoria appartiene un modello, controlla quali livelli sono pubblici:
- Pesi (file .safetensors): i parametri addestrati. Sono ciò che rende il modello eseguibile.
- Codice di inferenza e architettura: serve a caricare ed eseguire i pesi (per esempio le cartelle inference/ e encoding/ nel repository di DeepSeek).
- Codice di training e ricetta: iperparametri, pipeline di SFT, DPO, RL, log, checkpoint intermedi.
- Dati di training: dataset o informazioni sufficientemente dettagliate su origine e filtraggio.
Esempi: DeepSeek-V4.1-Flash pubblica pesi, codice di inferenza e technical report sotto licenza MIT; per quanto risulta dalla documentazione pubblica non pubblica il corpus di training da 45T token. Olmo 3 di Ai2 pubblica invece pesi, dati (famiglia Dolma 3), codice di training e checkpoint intermedi, tutto sotto Apache 2.0. Stessa licenza permissiva sui pesi, trasparenza molto diversa.
3. Licenze: permissive, custom e restrizioni d’uso
Licenze permissive (MIT, Apache 2.0). Consentono uso commerciale, modifica e redistribuzione con obblighi minimi (conservare il testo di licenza e le note di copyright). Sono licenze OSI-approved e i legali le conoscono: nessun contratto custom da negoziare. DeepSeek usa MIT; Mistral 3, Qwen3.6, gpt-oss e Gemma 4 usano Apache 2.0.
Licenze custom con restrizioni. La Llama 4 Community License è l’esempio tipico. Se i prodotti tuoi o delle tue affiliate superano 700 milioni di utenti attivi mensili devi chiedere una licenza a Meta, che può concederla a sua esclusiva discrezione. Include inoltre una Acceptable Use Policy incorporata e, per i modelli multimodali, esclude i soggetti con domicilio o sede principale nell’Unione Europea. Per un’azienda italiana quest’ultima clausola è un vincolo concreto da verificare sul testo di licenza. L’OSI ha dichiarato più volte che le licenze Llama non sono open source perché violano i punti 5 e 6 della Open Source Definition (discriminazione di persone e campi d’uso).
Il caso Gemma. Le versioni precedenti usavano una licenza proprietaria Google. Con Gemma 4 (primavera 2026) Google è passata ad Apache 2.0, descrivendola come la prima volta di una licenza OSI-approved per la famiglia. È un segnale di mercato: la pressione competitiva spinge verso licenze standard.
Policy d’uso. Anche con Apache 2.0 possono esistere policy accessorie: OpenAI, per esempio, distribuisce gpt-oss con Apache 2.0 più una usage policy. Checklist prima dell’adozione:
- leggi il file LICENSE nel repository e il campo license del model card;
- cerca soglie di utenti o ricavi, vincoli sui nomi dei modelli derivati e restrizioni geografiche;
- verifica se esiste una acceptable use policy collegata;
- conserva copia della licenza alla versione scaricata: i termini possono cambiare nelle release successive.
4. Stato dell’arte a Ottobre 2026
Addentriamoci nelle Differenza AI Open weight ed Open source. Il quadro, con le date ufficiali dei produttori:
- DeepSeek: V4 Preview il 24 aprile 2026 (V4-Pro da 1,6T parametri totali e 49B attivi, V4-Flash da 284B e 13B attivi, contesto 1M). Il 10 settembre 2026 arriva V4.1-Flash, che DeepSeek indica come superiore a V4-Pro per prestazioni, costi e velocità. Pesi sotto MIT.
- Qwen (Alibaba): Qwen3.5 a febbraio 2026 e Qwen3.6 ad aprile, con Qwen3.6-27B (denso) e Qwen3.6-35B-A3B (MoE) rilasciati come open weight sotto Apache 2.0.
- Mistral: famiglia Mistral 3 (2 dicembre 2025), con Mistral Large 3 (MoE da 675B totali e 41B attivi) e Ministral 3 da 3B, 8B e 14B, tutti Apache 2.0.
- Google: Gemma 4 (2026) sotto Apache 2.0, dalla taglia edge fino a 31B parametri.
- OpenAI: gpt-oss-120b e gpt-oss-20b (5 agosto 2025), Apache 2.0, primi modelli linguistici open weight di OpenAI dopo GPT-2.
- Meta: l’ultima famiglia Llama pubblicata è Llama 4 (Scout e Maverick, aprile 2025), ancora con licenza Community.
- Ai2: Olmo 3 (novembre 2025, 7B e 32B) e Olmo 3.1 32B (dicembre 2025), fully open sotto Apache 2.0.
Tre tendenze tecniche emergono: l’architettura Mixture-of-Experts è ormai dominante (pochi parametri attivi per token, molti residenti in memoria); i contesti lunghi (fino a 1M token) diventano standard; la quantizzazione nativa (FP8, FP4, MXFP4) è parte del rilascio. Sul piano della trasparenza, invece, il mercato è polarizzato: tanti open weight, pochissimi fully open.
5. DeepSeek nel dettaglio – Differenza AI Open weight ed Open source
DeepSeek è il caso di studio ideale perché mostra pregi e limiti dell’open weight al massimo livello di prestazioni.
Release e architettura. V4.1-Flash è un modello multimodale MoE da 552B parametri di backbone con architettura Causal Encoder-Decoder a 40 layer: attiva 8B parametri per token in prefill e 16B in decode. Il contesto arriva a 1M token. Usa 384 esperti instradati più uno condiviso, con 6 esperti attivi per token. È addestrato su 45T token e supporta un parametro di reasoning effort da 1 a 100. Nel repository Hugging Face il modello risulta di circa 763B parametri complessivi, perché include anche componenti come la memoria condizionale Engram e il vision encoder.
KV cache. È l’innovazione più utile per chi costruisce agenti. DeepSeek dichiara 890 byte di KV cache globale per token, circa un quarto rispetto a V4-Flash, e un quarto della memoria HBM e un ottavo dello storage SSD. Nei carichi agentic, dove il prefisso si ripete a ogni step, la cache pesa molto sul costo: comprimerla abbassa il prezzo del servizio.
Prestazioni dichiarate. Nel model card (reasoning effort massimo) V4.1-Flash ottiene 90,9 su GPQA Diamond, 90,6 su Terminal-Bench 2.1 e 74,2 su DeepSWE v1.1. Sono numeri del produttore, ma i modelli di confronto sono nella stessa tabella e il repository include le istruzioni per riprodurre i risultati DeepSWE.
Licenza e categoria. Pesi e repository sono sotto MIT: massima libertà d’uso commerciale. Resta però un modello open weight: i dati di training non sono pubblicati e il codice completo di training non fa parte del rilascio. MIT sui pesi non equivale a open source AI secondo OSAID.
Prezzi API. Il modello si chiama deepseek-flash. Nelle tariffe ufficiali off-peak sono $0,15 per milione di token di input (cache miss), $0,003 con cache hit e $0,60 per milione di output; le tariffe peak sono il doppio, perché l’off-peak vale il 50%. Controlla sempre la pagina prezzi, che DeepSeek aggiorna spesso.
Cosa devi sapere da sviluppatore:
- Gli alias cambiano. deepseek-chat e deepseek-reasoner sono stati ritirati il 24 luglio 2026; deepseek-v4-flash e deepseek-v4-pro ora vengono instradati verso V4.1-Flash, e DeepSeek sta dismettendo V4-Pro in attesa di V4.1-Pro. Fissa la versione dei pesi se ti serve riproducibilità.
- Nessun chat template Jinja. Il rilascio fornisce un’implementazione Python di riferimento (encoding/) e la libreria deepseek-recipe per codificare prompt, tool call e reasoning.
- Compatibilità API. L’endpoint supporta il formato OpenAI (https://api.deepseek.com) e quello Anthropic (/anthropic), quindi la migrazione dei client è minima.
- Deploy. Per grandi volumi DeepSeek parla esplicitamente di scenari con 2.000 GPU e un cluster di storage: il self-hosting completo non è un progetto da workstation.
6. Costi inferiori e limiti infrastrutturali – Differenza AI Open weight ed Open source
Costi inferiori, ma non gratis. Il vantaggio economico viene da due fonti: nessuna licenza per token verso il produttore del modello, e la possibilità di scegliere il provider più conveniente o di ospitare in proprio. Sull’API il divario è già visibile: Mistral Large 3 è listato a $0,5 per milione di token in input e $1,5 in output; DeepSeek V4.1-Flash scende, off-peak, a $0,15 e $0,60. Quando passi al self-hosting, il costo si sposta su GPU, energia e persone.
Il limite vero è la memoria, non il calcolo. In un modello MoE i parametri attivi per token sono pochi, ma tutti i parametri devono stare in memoria. Per stimare l’ordine di grandezza basta una moltiplicazione:
# Stima della memoria necessaria per i soli pesi di un modello

def memoria_pesi_gb(parametri_miliardi: float, bit_per_parametro: float) -> float:

    # miliardi di parametri x byte per parametro = GB (ordine di grandezza)

    return parametri_miliardi * bit_per_parametro / 8

# gpt-oss-120b: 117B parametri totali, quantizzazione MXFP4 (~4,25 bit/parametro)

print(f"gpt-oss-120b  (MXFP4): {memoria_pesi_gb(117, 4.25):.0f} GB")

# Qwen3.6-27B in BF16 (16 bit)

print(f"Qwen3.6-27B   (BF16) : {memoria_pesi_gb(27, 16):.0f} GB")

# DeepSeek-V4.1-Flash: ~763B parametri nel repository, ipotesi FP8 (8 bit)

print(f"DeepSeek V4.1 (FP8)  : {memoria_pesi_gb(763, 8):.0f} GB")

# KV cache globale di DeepSeek-V4.1-Flash: 890 byte per token (model card)

byte_per_token = 890

contesto = 1_000_000

print(f"KV cache globale a 1M token: {byte_per_token * contesto / 1e9:.2f} GB per sequenza")
I dati ufficiali confermano l’ordine di grandezza: OpenAI dichiara che gpt-oss-120b gira entro 80 GB di memoria (e gpt-oss-20b entro 16 GB); Mistral indica per Large 3 un checkpoint NVFP4 eseguibile su un singolo nodo 8×A100 o 8×H100 con vLLM. DeepSeek V4.1-Flash, con oltre 700 GB di soli pesi in questa stima, richiede cluster multi-GPU.
Altri limiti da mettere a budget:
- Supporto degli inference engine: i modelli con architetture nuove (come CSA2 o Engram di DeepSeek) richiedono versioni recenti di vLLM o SGLang; DeepSeek stessa dichiara di lavorare con la community per il supporto.
- MLOps: monitoraggio, aggiornamenti dei pesi, quantizzazione, valutazione continua sono a carico tuo.
- Licenza e compliance: soglie di utenti, restrizioni geografiche e policy d’uso (sezione 3).
- Sicurezza: con i pesi in mano chiunque può rimuovere i guardrail con un fine-tuning; la sicurezza applicativa diventa responsabilità del tuo layer.
7. Esempio pratico 1: verificare licenza e contenuto di un modello con Python
Scenario. Un team deve scegliere un modello per un assistente interno e il legale chiede: «che licenza ha, e cosa possiamo ispezionare?». Prima di leggere i model card uno per uno, automatizzi il primo controllo con la libreria huggingface_hub.
Passo 1: installa la libreria.
pip install huggingface_hubPasso 2: interroga i repository. Lo script legge licenza, numero di shard dei pesi e dataset eventualmente dichiarati nel model card.
from huggingface_hub import HfApi

api = HfApi()  # per repository pubblici non serve alcun token

# Repository ufficiali da confrontare

repos = [

    "deepseek-ai/DeepSeek-V4.1-Flash",

    "allenai/Olmo-3-1125-32B",

    "openai/gpt-oss-20b",

    "Qwen/Qwen3.6-27B",

]

for repo in repos:

    info = api.model_info(repo)

    meta = info.card_data

    # Licenza dichiarata nei metadati del model card

    licenza = meta.license if meta and meta.license else "non dichiarata"

    # Numero di file .safetensors = shard dei pesi presenti nel repository

    nomi_file = [f.rfilename for f in info.siblings]

    shard = sum(1 for n in nomi_file if n.endswith(".safetensors"))

    # Dataset di training dichiarati nel model card (se presenti)

    dataset = getattr(meta, "datasets", None) or []

    print(f"{repo}")

    print(f"  licenza: {licenza} | shard pesi: {shard} | dataset dichiarati: {len(dataset)}")
Passo 3: interpreta il risultato. Lo script ti dice se ci sono i pesi e sotto quale licenza, ma non può dirti se i dati di training sono davvero pubblici: un campo datasets vuoto è un indizio, non una prova. Per la classificazione open weight o open source servono sempre model card e technical report. Con questo metodo il team documenta in pochi minuti una scelta difendibile davanti al legale.
8. Esempio pratico 2: stesso codice client su modello locale e su API open weight
Scenario. Vuoi sviluppare in locale con un modello open weight e poi spostare lo stesso codice su un’API ospitata, senza riscrivere il client. È possibile perché sia vLLM sia DeepSeek espongono un’interfaccia compatibile con quella di OpenAI.
Passo 1: avvia il modello in locale (richiede una GPU con almeno 16 GB, come indicato da OpenAI per gpt-oss-20b).
pip install vllm openai

vllm serve openai/gpt-oss-20b --port 8000
Passo 2: scrivi un client unico e cambia solo base_url, chiave e nome del modello.
import os

from openai import OpenAI

def chiedi(client: OpenAI, modello: str, domanda: str) -> str:

    # Funzione unica, valida per qualsiasi server compatibile OpenAI

    risposta = client.chat.completions.create(

        model=modello,

        messages=[

            {"role": "system", "content": "Sei un assistente tecnico conciso."},

            {"role": "user", "content": domanda},

        ],

        max_tokens=1000,

    )

    return risposta.choices[0].message.content

domanda = "Spiega in tre righe la differenza tra open weight e open source."

# 1) Modello open weight eseguito in locale con vLLM

locale = OpenAI(base_url="http://localhost:8000/v1", api_key="non-necessaria")

print(chiedi(locale, "openai/gpt-oss-20b", domanda))

# 2) Stesso codice sull'API di DeepSeek (modello open weight ospitato dal produttore)

deepseek = OpenAI(

    base_url="https://api.deepseek.com",

    api_key=os.environ["DEEPSEEK_API_KEY"],  # imposta la variabile d'ambiente

)

print(chiedi(deepseek, "deepseek-flash", domanda))
Cosa ottieni. Sviluppo e dati sensibili restano on-premise sul modello locale; il carico di produzione può andare sull’API più economica senza toccare la logica applicativa. È il vantaggio pratico principale dell’ecosistema open weight: portabilità e assenza di lock-in. Gli script sono stati scritti sulla base della documentazione ufficiale: testali nel tuo ambiente prima dell’uso in produzione.
9. Tabella comparativa: differenze tecniche e di performance – Differenza AI Open weight ed Open source
Esempi di modelli open source (fully open) e open weight. Le prestazioni sono quelle dichiarate dai produttori; le stime di memoria sono calcolate dai parametri.
| Modello | Categoria e licenza | Architettura | Contesto | Requisiti indicativi | Performance dichiarate |
| Olmo 3 / 3.1 32B (Ai2) | Open source (fully open). Apache 2.0. Pesi, dati Dolma 3, codice, checkpoint | Denso, 32B; base su 5,5T token | 65.536 | 32B in BF16: circa 64 GB (stima) | Ai2: tra i migliori fully open a 32B; confronti nel model card con Qwen 3 32B e Gemma 3 27B |
| DeepSeek-V4.1-Flash | Open weight. MIT | MoE 552B backbone, 8B/16B attivi (prefill/decode), multimodale | 1M | Oltre 700 GB di pesi (stima): cluster multi-GPU | GPQA Diamond 90,9; Terminal-Bench 2.1 90,6; DeepSWE 74,2 (reasoning max) |
| Mistral Large 3 | Open weight. Apache 2.0 | MoE 675B totali, 41B attivi, multimodale | vedi docs Mistral | Checkpoint NVFP4 su un nodo 8×A100/H100 | Al debutto #2 tra gli open non-reasoning e #6 tra gli open su LMArena |
| gpt-oss-120b / 20b (OpenAI) | Open weight. Apache 2.0 + usage policy | MoE: 117B (5,1B attivi) / 21B (3,6B attivi) | 128k | 80 GB / 16 GB (MXFP4) | 120b vicino a o4-mini sui benchmark di ragionamento; 20b simile a o3-mini |
| Qwen3.6-27B | Open weight. Apache 2.0 | Denso 27B, multimodale | 262.144 (config server) | 27B in BF16: circa 54 GB (stima) | Alibaba: supera Qwen3.5-397B-A17B sui benchmark di agentic coding |
| Gemma 4 (Google) | Open weight. Apache 2.0 | Famiglia da edge fino a 31B | vedi model card | Da dispositivi edge a workstation | Google: la famiglia più capace di Gemma finora; verifica i benchmark nel model card |
| Llama 4 Scout / Maverick (Meta) | Open weight. Llama 4 Community License | MoE, 17B attivi: Scout 16 esperti, Maverick 128 esperti | 10M / 1M | Scout pensato per singola GPU H100 (quantizzato) | Competitivo alla release (aprile 2025); oggi non più sulla frontiera open weight (valutazione dell’autore) |
Come leggere la tabella. I parametri attivi determinano velocità e costo di calcolo; i parametri totali determinano la memoria necessaria. Il contesto massimo dichiarato non coincide con quello utile in produzione, che dipende dalla KV cache disponibile. Nessuna cella di performance è confrontabile con un’altra senza controllare benchmark, versione e reasoning effort.
10. Scenari futuri e competizione
Il divario con i modelli closed si è ridotto ma esiste ancora. Nella tabella del model card di DeepSeek (reasoning massimo, dati dichiarati dal produttore) V4.1-Flash è sopra o alla pari dei modelli proprietari su alcuni test e sotto sui più difficili:
| Benchmark | Opus-5.0 | GPT-5.6 Sol | DeepSeek-V4.1-Flash |
| GPQA Diamond | 93,4 | 94,1 | 90,9 |
| Humanity’s Last Exam | 56,3 | 44,5 | 36,8 |
| Terminal-Bench 2.1 | 89,1 | 88,8 | 90,6 |
| Terminal-Bench 4.0 | 51,8 | 39,9 | 31,2 |
| DeepSWE v1.1 | 74,0 | 73,0 | 74,2 |
Gli scenari plausibili, con la logica che li sostiene:
- Convergenza sulle licenze permissive. Il passaggio di Gemma ad Apache 2.0 e l’uso di MIT e Apache da parte di DeepSeek, Qwen, Mistral e OpenAI mettono pressione sulle licenze custom. Chi mantiene soglie e restrizioni rischia di perdere adozione tra gli sviluppatori.
- Gara all’efficienza, non solo ai parametri. I rilasci recenti competono su KV cache, MoE sparso, precisione FP4 e speculative decoding. Il vantaggio competitivo si sposta dal modello più grande al costo per token servito.
- Strategie ibride. I laboratori rilasciano modelli aperti di fascia media o alta e tengono i migliori dietro API: è il caso di OpenAI con gpt-oss e dei prodotti proprietari separati di Alibaba. L’open weight diventa anche leva commerciale e di distribuzione.
- Pressione sui prezzi delle API. Con pesi liberi, qualunque provider può servire lo stesso modello: la competizione si sposta su latenza, affidabilità e prezzo, con ribassi come quelli di DeepSeek off-peak.
- Fully open come nicchia strategica. Olmo 3 mostra che trasparenza totale è possibile a 32B, ma i modelli di frontiera restano open weight. Il valore dei fully open sarà nei settori regolati e nella ricerca, dove serve auditare dati e training.
- Instabilità delle versioni. DeepSeek ha già ritirato alias e instradato V4-Pro su V4.1-Flash: nei prossimi anni gli sviluppatori dovranno trattare i modelli come dipendenze versionate, con pesi fissati e test di regressione.
La competizione futura sarà quindi su tre assi: capacità sui compiti agentic più difficili (dove il divario con i closed è più marcato), costo di servizio (dove l’open weight è in vantaggio) e chiarezza di licenza e trasparenza (dove si decide l’adozione enterprise).
11. Conclusioni, fonti e formazione professionale
La differenza tra open weight e open source è pratica: determina cosa puoi auditare, riprodurre e cambiare, e sotto quali condizioni legali puoi portare il modello in produzione. Oggi puoi scegliere tra modelli aperti molto capaci, spesso con licenze semplici, che girano in locale o su API a costi molto più bassi del passato.
I modelli AI stanno rivoluzionando il lavoro degli sviluppatori software. Agenti di coding, assistenti integrati nell’IDE, pipeline RAG e applicazioni LLM sono già strumenti quotidiani, e i benchmark agentic sopra mostrano che la capacità cresce di mese in mese. Chi non si aggiorna rischia un divario tecnologico così ampio da finire ai margini del mercato: non perché «l’AI sostituisce gli sviluppatori», ma perché gli sviluppatori che sanno usarla producono, verificano e rilasciano a una velocità che chi lavora come cinque anni fa non può eguagliare. Saper scegliere un modello, valutarne la licenza, integrarlo in un’applicazione e governarne costi e rischi è ormai una competenza professionale di base.
Come colmare il divario. Ti consiglio fortemente i percorsi di AI Generativa di Innovaformazione: In particolare:
- Corso Sviluppo applicazioni LLM: per imparare a progettare e realizzare applicazioni basate su modelli linguistici, anche open weight:
- Corso Claude Code per sviluppatori: per integrare l’agentic coding nel flusso di lavoro quotidiano:
Formazione finanziabile con Fondimpresa o altri fondi interprofessionali.
Contatti
Per informazioni e preventivi scrivi a info@innovaformazione.net o chiama il 3471012275 (Dario Carrassi).
Per altri articoli di settore consigliamo di navigare sul nostro blog QUI.
Articoli correlati

Claude Code con Arduino

Novità .Net 11

Backdoor nei modelli AI open-weight

Opportunità di lavoro Bari

Spieghiamo il Weight space programming
