


Guida LLM Wiki
Guida LLM Wiki
Un LLM Wiki è una base di conoscenza in Markdown che un modello linguistico costruisce e mantiene per voi, invece di ripescare frammenti di documenti a ogni domanda come fa un sistema RAG. In questa guida scoprite cos’è, quando nasce, come funzionano i suoi tre livelli, in cosa si differenzia dal RAG e come costruirne uno passo dopo passo con GitHub, Python e Claude Code.
Indice dei contenuti – Guida LLM Wiki
1. Cos’è un LLM Wiki e quando nasce
2. A cosa serve e quali sono le caratteristiche fondamentali
3. I tre livelli di un LLM Wiki
4. Le tre operazioni: ingest, query e lint
5. LLM Wiki e RAG: confronto sintetico
6. Primo esempio pratico: la wiki del team IT su GitHub
7. Secondo esempio pratico: ingest, lint e query con Python
8. Automatizzare con GitHub Actions e una panoramica su Claude Code
9. Limiti, rischi e buone pratiche
10. Conclusioni: l’AI agentica è già dentro le aziende informatiche
1. Cos’è un LLM Wiki e quando nasce
Iniziamo la nostra Guida LLM Wiki con un racconto.Marta guida un team di sviluppo in una software house. Ogni sei mesi riapre la wiki aziendale e scopre sempre la stessa cosa: pagine obsolete, procedure duplicate, un post-mortem che contraddice l’architettura descritta due cartelle più in là. Nessuno ha colpa: mantenere una wiki costa fatica e, dopo un po’, la fatica supera il valore. Così Marta prova a caricare tutto in un chatbot con ricerca sui documenti e scopre un secondo problema: a ogni domanda l’assistente riparte da zero, recupera qualche frammento e lo ricompone. Nulla si accumula.
È da qui che parte l’idea di LLM Wiki. Il 4 aprile 2026 Andrej Karpathy ha pubblicato su GitHub Gist un file chiamato llm-wiki.md, che oggi conta oltre 5.000 star e oltre 5.000 fork. Lo definisce un “idea file”: non un software, ma un pattern da incollare nel proprio agente (Codex, Claude Code, OpenCode e simili), che poi costruisce i dettagli insieme a voi.
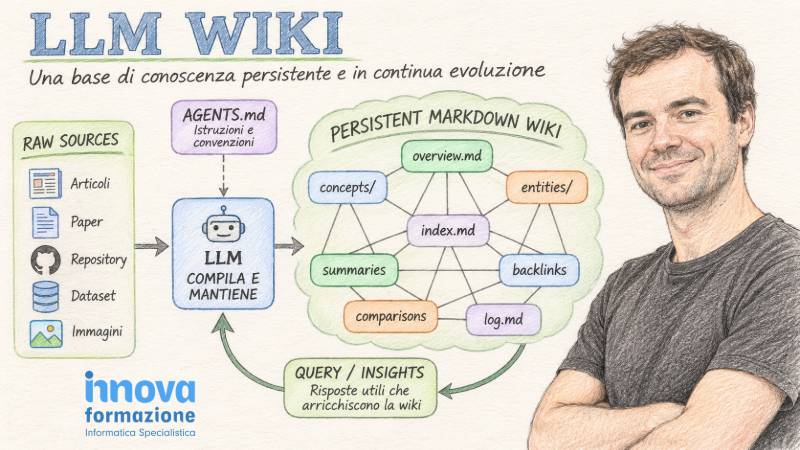
Il cuore dell’idea è semplice. Invece di recuperare frammenti dai documenti grezzi al momento della domanda, l’LLM costruisce e aggiorna in modo incrementale una wiki persistente: una raccolta strutturata e interconnessa di file Markdown che si trova tra voi e le fonti. Quando aggiungete una fonte, il modello non si limita a indicizzarla. La legge, estrae le informazioni chiave, le integra nelle pagine esistenti, rivede le sintesi e segnala dove i nuovi dati contraddicono quelli vecchi. La conoscenza viene compilata una volta e poi tenuta aggiornata, invece di essere ricostruita a ogni query.
Karpathy la spiega con una metafora per sviluppatori: l’editor di note (Obsidian, nel suo caso) è l’IDE, l’LLM è il programmatore e la wiki è la codebase. Il precedente culturale è il Memex di Vannevar Bush (1945), una raccolta personale di documenti collegati da percorsi associativi. Bush non sapeva però chi avrebbe fatto la manutenzione. Oggi, risponde Karpathy, se ne occupa il modello.
Perché proprio adesso? Perché per la prima volta esistono agenti in grado di lavorare su una cartella di file: leggono decine di pagine, le modificano in coerenza fra loro e lasciano una traccia leggibile. Il gist nasce infatti per essere consegnato a un agente di programmazione, che ne ricava un’implementazione adatta al vostro contesto. Per uno sviluppatore il paradigma è familiare: si parte da una specifica ad alto livello e si lascia all’agente la parte esecutiva, restando responsabili di architettura e revisione.
2. A cosa serve e quali sono le caratteristiche fondamentali
Entriamo nel vivo della Guida LLM Wiki. La parte noiosa di una knowledge base non è leggere o pensare, ma fare la contabilità: aggiornare i riferimenti incrociati, tenere attuali i riassunti, accorgersi che un dato nuovo smentisce uno vecchio. Gli esseri umani abbandonano le wiki perché il costo di manutenzione cresce più in fretta del valore. Un LLM non si annoia, non dimentica un link e può toccare quindici file in un solo passaggio.
Il gist elenca diversi ambiti d’uso: conoscenza personale, ricerca approfondita su un tema, lettura di un libro capitolo per capitolo, analisi competitiva e due diligence, e soprattutto la wiki interna di un team, alimentata da thread di chat, trascrizioni di riunioni e documenti di progetto, con revisione umana degli aggiornamenti. Per un’azienda IT è il caso più interessante: procedure, post-mortem e decisioni architetturali sono conoscenza che si accumula nel tempo.
Le caratteristiche fondamentali sono sei:
- Persistente e cumulativa: la wiki cresce a ogni fonte e a ogni domanda, i collegamenti e le sintesi sono già pronti.
- Scritta dall’LLM, letta da voi: il modello crea e aggiorna le pagine, voi scegliete le fonti, ponete le domande e verificate.
- Markdown e Git: sono file di testo in un repository, quindi cronologia, branch e collaborazione arrivano gratis.
- Contraddizioni visibili: quando una fonte nuova smentisce una vecchia, la discrepanza viene annotata invece di restare nascosta.
- Risposte che si archiviano: un confronto o un’analisi utile può diventare una nuova pagina, invece di perdersi nella cronologia di una chat.
- Modulare: ogni elemento (immagini, ricerca, slide) è opzionale, e il gist stesso invita a prendere solo ciò che serve.
3. I tre livelli di un LLM Wiki
Pensate a una redazione giornalistica. Ci sono l’archivio delle fonti originali, che nessuno riscrive. Ci sono gli articoli e le schede di approfondimento, scritti e aggiornati dai redattori. E c’è il manuale di stile, che dice come lavorare. Un LLM Wiki ha la stessa architettura, in tre livelli.
Livello 1: le fonti grezze (raw sources). È la vostra collezione curata di documenti: articoli, paper, immagini, file di dati. Sono immutabili: l’LLM le legge ma non le modifica mai, e costituiscono la fonte di verità. Se una pagina della wiki sembra sospetta, si torna sempre qui. Per far entrare le fonti si possono usare strumenti come Obsidian Web Clipper, che converte le pagine web in Markdown, e conviene scaricare in locale le immagini, così l’LLM non dipende da URL che potrebbero rompersi.
Livello 2: la wiki. È una directory di file Markdown generati dall’LLM: riassunti delle fonti, pagine di entità e di concetti, confronti, una panoramica, una sintesi. Questo livello appartiene interamente al modello, che crea le pagine, le aggiorna quando arrivano nuove fonti, mantiene i riferimenti incrociati e la coerenza. Voi leggete, lui scrive. Due file speciali aiutano la navigazione: index.md, il catalogo dei contenuti con un link e una riga di sintesi per pagina, e log.md, il registro cronologico delle operazioni.
Livello 3: lo schema. È il documento che dice all’LLM come è organizzata la wiki, quali convenzioni seguire e quali procedure applicare quando importa una fonte, risponde a una domanda o fa manutenzione. Con Claude Code si chiama CLAUDE.md, con Codex AGENTS.md. È il file che trasforma il modello da chatbot generico a manutentore disciplinato, e lo farete evolvere insieme a lui. La documentazione ufficiale di Claude Code precisa che CLAUDE.md viene caricato a ogni inizio sessione ma è contesto, non configurazione vincolante: per bloccare davvero un’azione serve un hook PreToolUse. Ricordatevelo quando deciderete cosa lasciare libero all’agente.
Ecco come si presenta, in pratica, la struttura di un repository con i tre livelli (i nomi delle sottocartelle sono una convenzione, potete cambiarli):
it-wiki/

├── raw/                  # Livello 1: fonti immutabili

├── wiki/                 # Livello 2: scritto e mantenuto dall'LLM

│   ├── index.md          # catalogo dei contenuti

│   ├── log.md            # registro cronologico

│   ├── sources/          # un riassunto per ogni fonte

│   ├── entities/         # servizi, sistemi, persone, clienti

│   ├── concepts/         # pattern, decisioni, procedure

│   └── analyses/         # confronti e risposte archiviate

└── CLAUDE.md             # Livello 3: lo schema
4. Le tre operazioni: ingest, query e lint – Guida LLM Wiki
Sopra i tre livelli lavorano tre operazioni, che vanno descritte nello schema.
Ingest. Mettete una nuova fonte in raw/ e chiedete all’LLM di elaborarla. Nel flusso descritto da Karpathy il modello legge la fonte, discute con voi i punti chiave, scrive una pagina di riassunto, aggiorna l’indice, aggiorna le pagine di entità e concetti coinvolte e aggiunge una riga al log. Una singola fonte può toccare dieci-quindici pagine. L’autore preferisce importare una fonte alla volta restando coinvolto, ma è possibile anche l’importazione in blocco con meno supervisione.
Query. Fate domande alla wiki. Il modello cerca le pagine rilevanti, le legge e sintetizza una risposta con citazioni. La risposta può essere testo, una tabella di confronto, un grafico o una presentazione. Il punto chiave è che le risposte buone possono essere archiviate nella wiki come nuove pagine, così le vostre esplorazioni si accumulano come le fonti.
Lint. Periodicamente chiedete un controllo di salute: contraddizioni fra pagine, affermazioni superate, pagine orfane senza link in ingresso, concetti citati ma privi di pagina, riferimenti mancanti, lacune colmabili con una ricerca.
Il registro merita un trucco. Se ogni voce di log.md inizia con un prefisso coerente, per esempio ## [2026-04-02] ingest | Titolo, il log si può interrogare con semplici strumenti Unix:
# Ultime 5 operazioni registrate nella wiki

grep "^## \[" wiki/log.md | tail -5
Quanto a index.md, il gist osserva che a scala moderata (circa cento fonti e qualche centinaio di pagine) funziona sorprendentemente bene e evita di costruire un’infrastruttura di embedding. Quando la wiki cresce serve una ricerca vera: l’autore cita qmd, un motore di ricerca locale per file Markdown con ricerca ibrida BM25/vettoriale, ma ricorda che anche uno script semplice scritto con l’aiuto dell’LLM può bastare.
5. LLM Wiki e RAG: confronto sintetico
Il RAG (Retrieval-Augmented Generation) è descritto nel paper del 2020 di Patrick Lewis e colleghi, che combina una memoria parametrica (un modello seq2seq pre-addestrato) con una memoria non parametrica, un indice vettoriale di Wikipedia consultato da un retriever neurale. Da allora è diventato lo schema standard per far rispondere un LLM su documenti propri. Karpathy non lo butta via: osserva però che, in un RAG tipico, il modello riscopre la conoscenza da zero a ogni domanda, e una domanda che richiede di sintetizzare cinque documenti costringe a ricomporre ogni volta i frammenti. Ecco le differenze principali:
Tabella Guida LLM Wiki vs RAG
| Aspetto | RAG classico | LLM Wiki |
| Quando si elabora la conoscenza | Al momento della domanda | Al momento dell’ingest, poi tenuta aggiornata |
| Unità di lavoro | Chunk di documenti grezzi | Pagine Markdown interconnesse |
| Accumulo | Nessuno: ogni query riparte da zero | Cumulativo: ogni fonte e risposta arricchisce la wiki |
| Contraddizioni | Emergono solo se i chunk giusti vengono recuperati | Segnalate in fase di ingest e di lint |
| Infrastruttura | Embedding, vector database, retriever | File Markdown, Git, indice testuale (ricerca opzionale) |
| Costo | Concentrato nelle query | Spostato sull’ingest e sulla manutenzione |
| Verificabilità | Citazione dei chunk | Pagine leggibili e versionate, con rimando alle fonti |
| Rischio tipico | Recupero dei frammenti sbagliati | Errori di sintesi che si propagano nelle pagine |
Non sono mondi in conflitto. Il RAG resta ottimo per grandi corpora eterogenei e per domande imprevedibili, la wiki per un dominio ben delimitato in cui la conoscenza evolve nel tempo. Sono comunque approcci combinabili: una wiki grande può usare una ricerca ibrida come strato di accesso.
6. Primo esempio pratico: la wiki del team IT su GitHub
La Guida LLM Wiki entra nel pratico. Torniamo a Marta. Decide di costruire la wiki del suo team con un caso minimo: procedure di deploy, post-mortem e decisioni architetturali. Serve solo un account GitHub, Git, Python e un agente (Claude Code, oppure uno script come quello del prossimo paragrafo).
Passo 1: creare il repository. Create su GitHub un repository privato (per esempio it-wiki) e clonatelo in locale. Un repository privato è la scelta prudente, perché la wiki conterrà conoscenza interna dell’azienda.
Passo 2: creare la struttura. Rispecchia i tre livelli:
git clone git@github.com:vostra-azienda/it-wiki.git && cd it-wiki

mkdir -p raw wiki/sources wiki/entities wiki/concepts wiki/analyses

printf "# Indice\n" > wiki/index.md

printf "# Log\n" > wiki/log.md

git add . && git commit -m "Struttura iniziale della wiki"
Passo 3: scrivere lo schema. È il file più importante. Partite da poche regole e fatelo crescere. Con Claude Code potete generare una bozza con il comando /init, che analizza il progetto e crea un CLAUDE.md iniziale, poi adattarla:
# Schema della wiki IT

## Regole

- `raw/` è immutabile: non modificare mai i file lì dentro.

- Scrivi solo in `wiki/`. Una pagina per entità o concetto.

- Collega le pagine con [[wikilink]] e cita sempre la fonte in `raw/`.

- Se una fonte contraddice una pagina, NON sovrascrivere: annota la

  discrepanza in una sezione "Contraddizioni" con le due fonti.

## Ingest

1. Leggi la fonte e `wiki/index.md`.

2. Crea `wiki/sources/<nome>.md` con un riassunto.

3. Aggiorna le pagine di entità e concetti toccate.

4. Aggiorna `wiki/index.md`.

5. Aggiungi a `wiki/log.md`: `## [AAAA-MM-GG] ingest | Titolo`
Passo 4: aggiungere la prima fonte. Copiate in raw/ il post-mortem dell’ultimo incidente, per esempio raw/2026-10-incidente-pagamenti.md, e fate un commit. Da qui in poi ogni fonte seguirà lo stesso percorso: file in raw/, ingest, revisione umana, commit.
Immaginate ora una settimana di lavoro. Il lunedì Marta importa il post-mortem dell’incidente, il martedì la procedura di rilascio, il mercoledì il verbale di una riunione sull’architettura. A ogni passaggio la wiki non si limita ad aggiungere un riassunto: aggiorna la pagina del servizio dei pagamenti, collega la procedura al post-mortem e, quando il verbale cita un timeout diverso da quello descritto nella procedura, annota la contraddizione con le due fonti affiancate. Il giovedì un collega chiede “perché abbiamo cambiato la strategia di retry?” e trova la risposta in una pagina già completa di decisioni, date e rimandi, senza riaprire tre documenti diversi. È il vantaggio di una conoscenza compilata una volta e tenuta aggiornata.
7. Secondo esempio pratico: ingest, lint e query con Python
Se non usate un agente come Claude Code, bastano poche righe di Python per automatizzare l’ingest. Lo script legge schema, indice e nuova fonte, chiede al modello le pagine da scrivere in formato JSON e le salva in wiki/. Installate l’SDK con pip install anthropic e impostate la variabile d’ambiente ANTHROPIC_API_KEY, che l’SDK legge automaticamente.
# ingest.py: versione minimale (richiede: pip install anthropic)

import json, pathlib, sys, datetime

import anthropic

ROOT = pathlib.Path(".")

client = anthropic.Anthropic()  # legge ANTHROPIC_API_KEY

def call_llm(system: str, user: str) -> str:

    msg = client.messages.create(

        model="claude-sonnet-5-5",

        max_tokens=4000,

        system=system,

        messages=[{"role": "user", "content": user}],

    )

    return "".join(b.text for b in msg.content if b.type == "text")

def ingest(source_path: str) -> None:

    schema = (ROOT / "CLAUDE.md").read_text(encoding="utf-8")

    index = (ROOT / "wiki/index.md").read_text(encoding="utf-8")

    source = pathlib.Path(source_path).read_text(encoding="utf-8")

    prompt = (

        f"INDICE ATTUALE:\n{index}\n\nNUOVA FONTE ({source_path}):\n{source}\n\n"

        'Rispondi SOLO con JSON: {"pages":[{"path":"wiki/...md",'

        '"content":"..."}],"log":"titolo breve"}'

    )

    data = json.loads(call_llm(schema, prompt))

    wiki_dir = (ROOT / "wiki").resolve()

    for p in data["pages"]:

        target = (ROOT / p["path"]).resolve()

        if not target.is_relative_to(wiki_dir):  # sicurezza: solo wiki/

            raise ValueError(f"Percorso non consentito: {p['path']}")

        target.parent.mkdir(parents=True, exist_ok=True)

        target.write_text(p["content"], encoding="utf-8")

    today = datetime.date.today().isoformat()

    with open(ROOT / "wiki/log.md", "a", encoding="utf-8") as f:

        f.write(f"\n## [{today}] ingest | {data['log']}\n")

if __name__ == "__main__":

    ingest(sys.argv[1])
Se preferite un altro provider o un modello locale, cambia solo il corpo di call_llm(). Per esempio, molti server locali espongono un’API compatibile con l’SDK OpenAI (verificate sempre nella documentazione del vostro provider):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:11434/v1", api_key="locale")

def call_llm(system: str, user: str) -> str:

    r = client.chat.completions.create(

        model="nome-del-modello-locale",

        messages=[{"role": "system", "content": system},

                  {"role": "user", "content": user}],

    )

    return r.choices[0].message.content
Attenzione al limite di questa versione: il modello vede l’indice, non il contenuto delle pagine esistenti, quindi può riscriverle in modo incompleto. In una wiki piccola potete passargli anche i file rilevanti; è proprio il tipo di lavoro che un agente come Claude Code svolge da solo, perché legge e modifica i file direttamente.
Il lint, invece, non richiede un LLM per i controlli strutturali. Questo script trova link rotti e pagine orfane (si aspetta i [[wikilink]] richiesti dallo schema):
# lint.py: link rotti e pagine orfane

import re, pathlib, sys

pages = {p.stem: p for p in pathlib.Path("wiki").rglob("*.md")}

linked, problems = set(), 0

for p in pages.values():

    for name in re.findall(r"\[\[([^\]|#]+)", p.read_text(encoding="utf-8")):

        name = name.strip()

        linked.add(name)

        if name not in pages:

            print(f"LINK ROTTO  {p}: [[{name}]]")

            problems += 1

for name, p in pages.items():

    if name not in linked and name not in ("index", "log"):

        print(f"ORFANA      {p}")

        problems += 1

sys.exit(1 if problems else 0)
Per la query, il flusso è lo stesso: l’LLM legge index.md, individua le pagine rilevanti, le legge e risponde con citazioni. Se la risposta vale, chiedetegli di salvarla in wiki/analyses/ e di aggiungerla all’indice.
8. Automatizzare con GitHub Actions e una panoramica su Claude Code
Passiamo alle automazioni nella nostra Guida LLM Wiki. GitHub offre già gli strumenti per mettere la wiki sotto controllo. Il primo è una pipeline che esegue il lint a ogni pull request che tocca wiki/. La documentazione di GitHub spiega che il filtro paths fa partire il workflow solo se cambia almeno un file corrispondente:
# .github/workflows/wiki-lint.yml

name: wiki-lint

on:

  pull_request:

    paths:

      - "wiki/**"

jobs:

  lint:

    runs-on: ubuntu-latest

    steps:

      - uses: actions/checkout@v4

      - uses: actions/setup-python@v5

        with:

          python-version: "3.12"

      - run: python lint.py
Il secondo livello è dare l’ingest a un agente. Claude Code è lo strumento di Anthropic che lavora direttamente sul repository: legge lo schema CLAUDE.md a ogni sessione, può leggere e modificare i file della wiki e, secondo la documentazione, mantiene anche una memoria automatica con note che scrive per sé. Esiste inoltre un’integrazione ufficiale con GitHub Actions, anthropics/claude-code-action, che esegue Claude Code dentro i vostri workflow, per esempio quando si menziona @claude in una pull request o in una issue. Un workflow di ingest automatico potrebbe assomigliare a questo (adattatelo alla guida ufficiale, in particolare per permessi e autenticazione):
# .github/workflows/wiki-ingest.yml

name: wiki-ingest

on:

  push:

    branches: [main]

    paths:

      - "raw/**"

permissions:

  contents: write

  pull-requests: write

  id-token: write

jobs:

  ingest:

    runs-on: ubuntu-latest

    steps:

      - uses: actions/checkout@v4

      - uses: anthropics/claude-code-action@v1

        with:

          anthropic_api_key: ${{ secrets.ANTHROPIC_API_KEY }}

          prompt: >

            Segui CLAUDE.md: esegui l'ingest delle nuove fonti in raw/

            e proponi le modifiche alla wiki in una pull request.

          claude_args: "--max-turns 10"
Notate le due protezioni: l’agente propone una pull request invece di scrivere direttamente su main, e il numero di turni è limitato. La revisione umana della pull request è il punto in cui il vostro ruolo di curatore diventa concreto. La chiave API va conservata nei secret del repository, mai nel codice.
9. Limiti, rischi e buone pratiche
Un LLM Wiki non è una bacchetta magica. Il rischio principale è che un errore di sintesi si propaghi: se il modello scrive male una pagina, le pagine collegate possono ereditare l’errore. Per questo le fonti restano immutabili, ogni affermazione deve rimandare a una fonte e le modifiche passano da una revisione. Il costo si sposta dalla query all’ingest e alla manutenzione, e nella discussione sotto il gist alcuni utenti riportano che il vantaggio non sempre compensa quel costo, soprattutto su corpora generici con domande imprevedibili (sono testimonianze individuali, non misure controllate). Lo stesso Karpathy specifica che il documento è volutamente astratto e che struttura, convenzioni e strumenti dipendono dal dominio.
Le buone pratiche, in sintesi: partite piccoli, con un solo dominio e poche fonti; importate una fonte alla volta e leggete i riassunti; scrivete nello schema regole esplicite (estendere le pagine esistenti, non duplicarle); fate girare il lint con regolarità; non mettete dati sensibili in un repository senza averne valutato accessi e conformità.
10. Conclusioni: l’AI agentica è già dentro le aziende informatiche
Il caso di Marta non è fantascienza. Pattern come l’LLM Wiki mostrano che agenti e modelli linguistici non sono più un esperimento da laboratorio: lavorano dentro i repository, nelle pipeline CI, nella documentazione e nei processi quotidiani di chi sviluppa software. Il mestiere si sposta: meno compilazione manuale di conoscenza e codice ripetitivo, più progettazione di schemi, verifica, revisione e scelta delle fonti. Sono competenze che si imparano, e il mercato le sta già richiedendo.
Pensate a cosa succede in un’azienda informatica tipo. Il team di sviluppo usa agenti per scrivere e rivedere codice, il supporto li usa per classificare ticket, chi gestisce la documentazione li usa per tenerla allineata. Chi sa progettare lo schema, controllare i risultati e individuare gli errori diventa il punto di riferimento; chi li usa senza capirli finisce per fidarsi di output che non sa verificare. La differenza non sta nell’avere accesso allo strumento, che è alla portata di tutti, ma nel saperlo governare con metodo.
Per questo chi oggi non si forma e non si aggiorna su queste tecnologie rischia di restare in fretta tagliato fuori. Formarsi non significa solo conoscere uno strumento, ma capire come progettare applicazioni basate su LLM, come orchestrare agenti e come integrarli in modo sicuro nel lavoro del team.
Innovaformazione propone un percorso di Corsi sull’AI generativa . Fra i più richiesti consigliamo:
I corsi sono rivolti alle aziende e vengono attivati su richiesta, in modalità online in classe virtuale, con un calendario da concordare. È possibile finanziarli con Fondimpresa.
Contatti
Per ricevere informazioni scrivete a info@innovaformazione.net oppure chiamate il 347 1012275 (Dario Carrassi).
Innovaformazione staff
Per altri articoli tecnici di settore consigliamo di navigare sul nostro blog QUI.
Articoli correlati

Claude Code con Arduino

Novità .Net 11

Backdoor nei modelli AI open-weight

Opportunità di lavoro Bari

Spieghiamo il Weight space programming
