


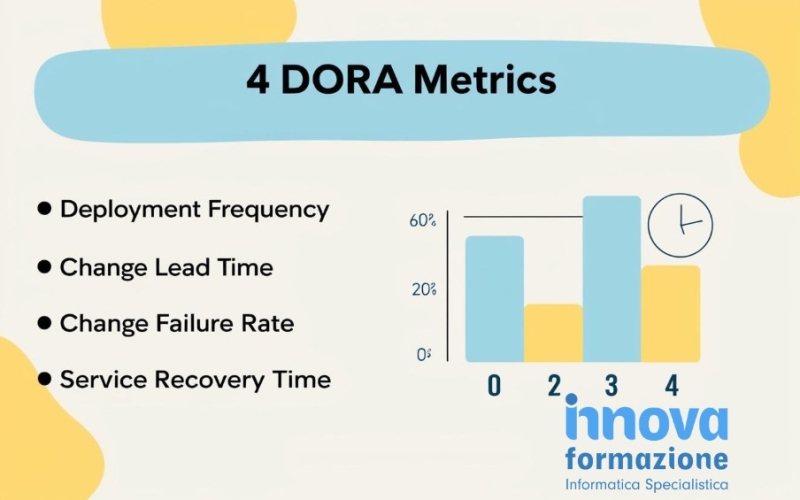
DORA DevOps Metriche
Per raggiungere il successo con DevOps, è necessario misurare l’efficacia delle proprie iniziative DevOps. Monitorare le giuste metriche DevOps aiuterà a valutare l’efficacia delle proprie pratiche DevOps.
In questo articolo spiegherò molte metriche DevOps, inclusa la loro importanza, le metriche chiave per vari obiettivi e, soprattutto, suggerimenti per migliorare il punteggio di ciascuna metrica DevOps qui discussa.
Metriche DevOps: sono necessarie?
Le metriche DevOps sono i dati che aiutano a misurare le prestazioni delle principali pratiche o processi DevOps, come:
- Integrazione continua (CI)
- Distribuzione continua
- Test automatizzati
- Monitoraggio continuo
Queste metriche consentono alle organizzazioni di monitorare i propri progressi: state raggiungendo gli obiettivi prefissati? Le metriche aiutano anche a identificare eventuali colli di bottiglia che impediscono di massimizzare le prestazioni delle applicazioni e la produttività dei dipendenti grazie ai processi DevOps. L’utilizzo di queste metriche vi consentirà di apportare i miglioramenti necessari e di ottenere il massimo ritorno sugli investimenti.
In questo articolo abbiamo suddiviso queste metriche in alcune categorie:
- Le quattro metriche chiave di DORA
- Ottimizzazione dei test e della qualità del codice
- Ottimizzazione della distribuzione
- Ottimizzazione dell’integrazione continua
- Misurazione della soddisfazione del cliente
- Ottimizzazione delle pratiche di monitoraggio
Metriche DORA DevOps
Un set di metriche DevOps ben noto proviene da DORA, il team DevOps Research and Assessment (DORA) di Google. Nel corso degli anni, DORA ha identificato ciò che distingue i team DevOps ad alte prestazioni. Queste quattro metriche sono definite grazie a oltre 7 anni di ricerca sui principi DevOps e sulle loro applicazioni pratiche.
Il framework DORA utilizza le quattro metriche chiave descritte di seguito per misurare due aree chiave del DevOps: velocità e stabilità. La frequenza di distribuzione e il tempo medio di esecuzione delle modifiche misurano la velocità del DevOps, mentre il tasso di errore delle modifiche e il tempo di ripristino del servizio misurano la stabilità del DevOps. Utilizzate insieme, queste quattro metriche DORA forniscono una base di riferimento per le prestazioni di un team DevOps e indicazioni su dove è possibile migliorarle.
Nella sezione seguente vengono spiegate brevemente queste quattro metriche DevOps chiave, cos’è un buon punteggio e come migliorarle.
Tasso di errore delle modifiche (CFR)
Il tasso di errore delle modifiche è la percentuale di distribuzioni che causano un errore in produzione che richiede una correzione immediata, come un degrado del servizio o un’interruzione. Un basso tasso di errore delle modifiche è auspicabile perché più tempo un team dedica alla risoluzione degli errori, meno tempo avrà a disposizione per fornire nuove funzionalità e valore al cliente. Questa metrica viene solitamente calcolata contando quante volte una distribuzione si è rivelata in errore e dividendo questo numero per il numero totale di distribuzioni per ottenere una media. Non tiene conto delle correzioni di bug prima della distribuzione in produzione. È possibile calcolare il CFR contando il numero di distribuzioni e, tra queste, quante hanno generato hotfix o rollback. Questa metrica può essere calcolata come segue:
(errori di distribuzione / distribuzioni totali) x 100
I parametri di riferimento per il tasso di fallimento delle modifiche sono:
- Élite: 0-15%
- Alto: 16-30%
- Medio: 16-30%
- Basso: 16-30%
Questa metrica è un buon indicatore di:
- La qualità del tuo codice
- L’efficacia dei tuoi metodi di test
Il CFR del tuo team dovrebbe essere compreso tra lo 0 e il 15% se segui pratiche DevOps efficaci. Pratiche come l’implementazione basata su trunk , l’automazione dei test e il lavoro a piccoli incrementi possono contribuire a migliorare questa metrica.
Frequenza di distribuzione (DF)
Il DF è una misura della frequenza con cui si distribuiscono le modifiche in produzione. I team più performanti di solito distribuiscono il codice in produzione su richiesta o più volte al giorno. Distribuire mensilmente o settimanalmente si tradurrà in un DF inferiore.
Questa metrica aiuta i team a:
- Rispondere alle mutevoli esigenze dei clienti.
- Correggi i bug più velocemente.
- Introdurre miglioramenti alle funzionalità esistenti.
- Ridurre i rischi associati a distribuzioni meno frequenti o più estese.
I parametri di riferimento per la frequenza di distribuzione sono:
- Elite : più distribuzioni al giorno
- Alto : una distribuzione a settimana o una al mese
- Medio : una distribuzione al mese o una ogni sei mesi
- Basso : meno di una distribuzione ogni sei mesi
Le organizzazioni variano nel modo in cui definiscono un’implementazione di successo e la frequenza delle implementazioni può variare persino tra i team all’interno di una stessa organizzazione.
Tempo di consegna delle modifiche (LT)
Il lead time è il tempo necessario affinché un commit di codice sia pronto per la produzione dopo aver superato tutti i test necessari nell’ambiente di pre-produzione. Calcola questa metrica utilizzando i tempi del commit del codice e dell’inizio del rilascio.
I team DevOps più maturi gestiscono il LT in poche ore, mentre i team con prestazioni medie o basse impiegano solitamente giorni o settimane. È possibile migliorare il LT implementando pratiche come il deployment basato su trunk, il lavoro in piccoli batch e l’automazione dei test.
I tempi medi di esecuzione per i benchmark delle modifiche sono:
- Elite : meno di uno all’ora
- Alto : tra un giorno e una settimana
- Medio : tra uno e sei mesi
- Basso : più di sei mesi
I processi culturali specifici di un’organizzazione, come team di test separati o ambienti di test condivisi, possono influire sui tempi di consegna e rallentare le prestazioni di un team.
Tempo medio per il ripristino del servizio (MTTR)
L’MTTR è il tempo necessario per il ripristino da un guasto totale o da un’interruzione parziale del servizio in un ambiente di produzione. I team ad alte prestazioni mantengono un MTTR inferiore a un’ora, mentre può arrivare fino a una settimana per i team a basse prestazioni. È possibile calcolare l’MTTR considerando l’ora in cui si è verificato un incidente e il tempo impiegato per risolverlo.
Il punteggio MTTR dipende dalla rapidità con cui si riesce a identificare un incidente quando si verifica e a implementare una soluzione. È possibile migliorare il punteggio MTTR monitorando costantemente sistemi e servizi e avvisando il personale interessato non appena si verifica un incidente. Questo consente loro di intraprendere rapidamente le azioni necessarie.
I benchmark del tempo di ripristino del servizio sono:
- Elite : meno di un’ora
- Alto : meno di un giorno
- Medio : tra un giorno e una settimana
- Basso : più di sei mesi
Applicazioni e casi d’uso per le metriche DORA
Le aziende di praticamente qualsiasi settore possono utilizzare le metriche DORA per misurare e migliorare le proprie prestazioni di sviluppo e distribuzione del software. Uno sviluppatore di giochi per dispositivi mobili, ad esempio, potrebbe utilizzare le metriche DORA per comprendere e ottimizzare la propria risposta quando un gioco va offline, riducendo al minimo l’insoddisfazione dei clienti e preservando i ricavi. Una società finanziaria potrebbe comunicare l’impatto positivo del DevOps sul business agli stakeholder aziendali, traducendo le metriche DORA in dollari risparmiati attraverso una maggiore produttività o una riduzione dei tempi di inattività.
Vantaggi e sfide delle metriche DORA
Le metriche DORA sono uno strumento utile per quantificare le prestazioni di distribuzione del software della tua organizzazione e confrontarle con quelle di altre aziende del tuo settore. Questo può portare a:
- Processo decisionale migliore : il monitoraggio costante delle metriche DORA aiuta le organizzazioni a utilizzare dati concreti per comprendere lo stato attuale del loro processo di sviluppo e prendere decisioni su come migliorarlo. Poiché DORA aiuta i team DevOps a concentrarsi su metriche specifiche anziché monitorare tutto, i team possono identificare più facilmente i colli di bottiglia nei loro processi, concentrare gli sforzi sulla loro risoluzione e convalidare i risultati. Il risultato finale è una delivery più rapida e di alta qualità, basata sui dati anziché sull’istinto.
- Maggiore valore : i team d’élite e ad alte prestazioni possono essere certi di offrire valore ai propri clienti e di avere un impatto positivo sul business. Le metriche DORA offrono inoltre ai team meno performanti una visione chiara di dove il loro processo potrebbe essere in stallo e li aiutano a individuare un percorso per generare maggiore valore.
- Miglioramento continuo : i team DevOps possono basare le proprie prestazioni con le metriche DORA e scoprire quali abitudini, policy, processi, tecnologie e altri fattori ostacolano la loro produttività. Le quattro metriche chiave forniscono un percorso per definire obiettivi volti a ottimizzare le prestazioni del team e determinare i modi più efficaci per farlo.
Sebbene le metriche DORA forniscano un punto di partenza per valutare le prestazioni di distribuzione del software, possono anche presentare alcune sfide. Le metriche possono variare notevolmente da un’organizzazione all’altra, il che può causare difficoltà nel valutare accuratamente le prestazioni dell’organizzazione nel suo complesso e nel confrontarle con quelle di un’altra organizzazione.
Ogni metrica in genere si basa anche sulla raccolta di informazioni da più strumenti e applicazioni. Determinare il tempo di ripristino del servizio, ad esempio, potrebbe richiedere la raccolta di dati da PagerDuty, GitHub e Jira. Le differenze negli strumenti utilizzati da un team all’altro possono complicare ulteriormente la raccolta e il consolidamento di questi dati.
Metriche DevOps per obiettivi diversi
Le metriche di DORA ci offrono un ottimo punto di partenza. Tuttavia, diverse altre metriche DevOps importanti aiutano a misurare il successo dei processi DevOps. Le analizzeremo nelle sezioni seguenti. Abbiamo suddiviso queste sezioni in metriche per test e qualità del codice, deployment, integrazione continua, soddisfazione del cliente e, infine, pratiche di monitoraggio.
Metriche per ottimizzare i test e la qualità del codice
Tasso di fuga dei difetti
Questa metrica misura il numero di difetti sfuggiti ai test di livello inferiore e trasferiti in produzione. I team dovrebbero mantenere questo valore vicino allo zero. Un tasso di fuga dei difetti più elevato indica che i processi di test necessitano di maggiore automazione e miglioramento.
I team DevOps dovrebbero individuare almeno il 90% dei difetti negli ambienti di pre-produzione prima di rilasciare il codice in produzione.
Tasso di fallimento del test CI
Questa metrica è un buon indicatore della qualità del codice. Puoi misurarla dividendo il numero di test falliti nella pipeline di CI per il numero totale di test eseguiti.
Un tasso elevato di errori nei test CI indica che il codice necessita di ulteriori miglioramenti e induce gli sviluppatori a eseguire i propri test unitari prima di eseguire il commit del codice.
Copertura del codice
La copertura del codice indica la quantità di codice testato dalla suite di test automatizzata. In genere, la migliore pratica DevOps è mantenere una copertura del codice automatizzata più elevata, poiché aiuta a rilevare rapidamente gli errori. Tuttavia, una copertura del 100% non garantisce la massima qualità del codice, poiché può includere test non necessari.
Metriche per ottimizzare la distribuzione e i flussi di lavoro
Tempo di ciclo
Il tempo di ciclo misura il tempo che intercorre tra l’inizio dei lavori su un elemento specifico e il momento in cui è pronto per gli utenti finali. Per i team di sviluppo , il tempo di ciclo è il tempo che intercorre tra il commit del codice e la sua distribuzione in produzione.
Più lungo è il tempo di ciclo, maggiore è il lavoro in corso e meno efficienti sono i flussi di lavoro. I team devono ottimizzare e migliorare l’efficienza dei propri flussi di lavoro per migliorare il tempo di ciclo.
Dimensioni della distribuzione
La dimensione del deployment è determinata dal numero di funzionalità, storie e correzioni di bug implementate. È possibile misurarla utilizzando il numero di story point completati per ciascun deployment. Combinando questa metrica con altre metriche come la frequenza di deployment e il tempo di ciclo, è possibile comprendere la produttività di ogni deployment.
Tempo di distribuzione
Il tempo di deployment è il tempo necessario per completare un deployment. È una metrica DevOps utile per misurare l’efficienza delle pipeline di deployment. Se il tempo di deployment è molto lungo, ovvero richiede molte ore, indica un potenziale problema e riduce la produttività del team di rilascio.
È possibile migliorare questa metrica rimuovendo i passaggi non necessari dalla pipeline di distribuzione e introducendo meccanismi di parallelizzazione.
Metriche di flusso
Le metriche di flusso sono un framework per misurare il valore generato da un flusso di valore di un prodotto e la velocità con cui viene generato dall’inizio alla fine. Mentre le metriche di performance tradizionali si concentrano su processi e attività specifici, le metriche di flusso misurano il flusso end-to-end dell’attività e i suoi risultati. Questo aiuta le organizzazioni a individuare gli ostacoli nel flusso di valore che impediscono il raggiungimento dei risultati desiderati.
Esistono quattro metriche di flusso principali per misurare i flussi di valore:
- La velocità del flusso misura il numero di elementi del flusso completati in un periodo per determinare se il valore sta accelerando.
- Il tempo di flusso misura quanto tempo è trascorso tra l’inizio e la fine di un elemento di flusso per misurare il tempo di immissione sul mercato.
- L’efficienza del flusso misura il rapporto tra tempo attivo e tempo di flusso totale per identificare gli sprechi nel flusso di valore.
- Il carico di flusso misura il numero di elementi di flusso in un flusso di valore per identificare il sovrautilizzo e il sottoutilizzo dei flussi di valore.
Le metriche di flusso aiutano le organizzazioni a comprendere i flussi che attraversano l’intero processo di distribuzione del software, sia dal punto di vista del cliente che da quello aziendale, indipendentemente dalle metodologie di distribuzione del software utilizzate. Questo fornisce una visione più chiara dell’impatto della distribuzione del software sui risultati aziendali.
Metriche per ottimizzare l’integrazione continua (CI)
CI corre al giorno
Questa metrica indica il conteggio delle esecuzioni giornaliere della pipeline di CI. I team più performanti eseguono più esecuzioni di CI al giorno, in genere 4 o 5 volte per sviluppatore. Indica la corretta prassi di release frequenti e trust nella pipeline di CI/CD.
Tasso di successo dell’IC
Le CI possono essere eseguite più volte al giorno, anche se ciascuna di esse potrebbe non avere successo. Il tasso di successo delle CI si misura dividendo il numero totale di CI riuscite per il numero totale di esecuzioni di CI. È preferibile avere un tasso di successo delle CI più elevato: ciò indica che i processi di CI/CD sono ben gestiti e che gli sviluppatori eseguono i test di sviluppo in modo efficace.
Metriche per misurare la soddisfazione del cliente
Naturalmente, l’obiettivo di tutto questo è soddisfare i clienti. Ecco cosa misurare.
Volume dei ticket dei clienti
Il numero di incidenti segnalati o ticket di supporto presentati dai clienti indica il livello di soddisfazione dei clienti rispetto ai tuoi prodotti. Questa metrica aiuta anche a monitorare il feedback dei clienti sulle tue release e fornisce visibilità sulla gravità dei problemi di produzione.
Un volume inferiore di ticket dei clienti indica che hai adottato gli approcci giusti e che hai bisogno solo di lievi miglioramenti.
Disponibilità/tempo di attività dell’applicazione
La disponibilità di un’applicazione è il periodo di tempo in cui l’applicazione è disponibile per gli utenti finali nel suo stato pienamente funzionale. Gli errori dell’applicazione possono causare tempi di inattività più lunghi, generando frustrazione tra gli utenti che tentano di accedervi. Per migliorare la disponibilità di un’applicazione, i team devono definire strategie come:
- Infrastruttura cloud ad alta disponibilità
- Scalabilità automatica
- Piani di disaster recovery (backup e ripristino)
- Meccanismi di sicurezza rigorosi
Prestazioni dell’applicazione
Questa metrica valuta le prestazioni dell’applicazione sotto stress e con diversi carichi utente. I team devono eseguire questi test prima della distribuzione in produzione in un ambiente di pre-distribuzione equivalente a quello di produzione.
Questa metrica consente loro di identificare transazioni che potrebbero fallire e difetti quando il sistema è sotto carico. In questo modo, possono ottimizzare il codice prima della distribuzione e fornire un’esperienza utente coerente.
Metriche per ottimizzare le pratiche di monitoraggio
Tempo medio di rilevamento (MTTD)
L’MTTD è il tempo necessario per rilevare un errore di produzione e segnalarlo come problema. Questa metrica aiuta a valutare l’efficacia dei sistemi di monitoraggio e avviso. Più basso è l’MTTD , maggiore è la probabilità di risolvere il problema e di mandarlo in produzione prima che influisca sugli utenti finali. È possibile migliorare l’MTTD:
- Utilizzo di strumenti di monitoraggio efficaci.
- Mantenere una buona copertura di monitoraggio delle applicazioni.
Utilizzo e traffico delle applicazioni
Questa metrica indica quanti utenti accedono ai loro sistemi e quante transazioni vengono eseguite in tempo reale. In caso di carico elevato, il rischio di guasti dei sistemi è elevato. Pertanto, è possibile mantenere il team DevOps sempre pronto a intervenire in caso di problemi.
Strumenti per il monitoraggio delle metriche DevOps e DORA
Una volta automatizzato il monitoraggio delle metriche DevOps, puoi iniziare a migliorare le prestazioni di distribuzione del software. Diversi tracker di metriche ingegneristiche catturano le metriche DevOps più comuni, tra cui:
- Faros
- Haystack
- LinearB
- Sleuth
- Velocity by Code Climate
Quando si considera un tracker di metriche, è importante assicurarsi che si integri con i principali sistemi di distribuzione del software, inclusi CI/CD, tracciamento dei problemi e strumenti di monitoraggio. Dovrebbe anche visualizzare le metriche in modo chiaro e in formati facilmente comprensibili, in modo che i team possano estrarre rapidamente informazioni, identificare tendenze e trarre conclusioni dai dati.
Metriche DevOps per una varietà di pratiche
Le metriche DevOps sono dati che consentono alle organizzazioni di valutare l’efficacia delle proprie pratiche DevOps e il loro contributo al raggiungimento degli obiettivi organizzativi. Le quattro metriche DevOps chiave includono il tasso di errore delle modifiche, la frequenza di distribuzione, il tempo di risposta alle modifiche e il tempo medio di ripristino dei servizi.
Inoltre, sono state identificate diverse altre metriche DevOps relative alle attività chiave di una pipeline di distribuzione del software, tra cui implementazione, test, monitoraggio ed esperienza utente finale. Queste metriche possono garantire risultati aziendali di successo misurandoli con i processi DevOps implementati dalle organizzazioni.
(fonte)
Innovaformazione, scuola informatica specialistica promuove le metodologie e le pratiche DevOps affiancando le aziende nella formazione continua dei team di sviluppatori. Potete visionare l’offerta formativa per le aziende navigando sul nostro sito QUI.
INFO: info@innovaformazione.net – tel. 3471012275 (Dario Carrassi)
Articoli correlati
Guida LLM Wiki

Claude Code con Arduino

Novità .Net 11

Backdoor nei modelli AI open-weight

Opportunità di lavoro Bari
